Cilium : le réseau Kubernetes propulsé par eBPF
Sur un cluster Kubernetes, chaque paquet traverse des couches de règles iptables, de proxys et de sidecars qui ralentissent le réseau et compliquent le diagnostic. Comment appliquer des politiques de sécurité fines sans alourdir chaque Pod ? Comment voir qui parle à qui dans un cluster de plusieurs centaines de nœuds ? Une technologie du noyau Linux apporte une réponse : eBPF, qui permet d'exécuter du code sûr directement dans le noyau, sans le modifier.
Équipe Blent
Publié le · 11 min de lecture
Dans cet article
Sur un cluster Kubernetes, chaque paquet traverse des couches de règles iptables, de proxys et de sidecars qui ralentissent le réseau et compliquent le diagnostic. Comment appliquer des politiques de sécurité fines sans alourdir chaque Pod ? Comment voir qui parle à qui dans un cluster de plusieurs centaines de nœuds ? Une technologie du noyau Linux apporte une réponse : eBPF, qui permet d'exécuter du code sûr directement dans le noyau, sans le modifier.
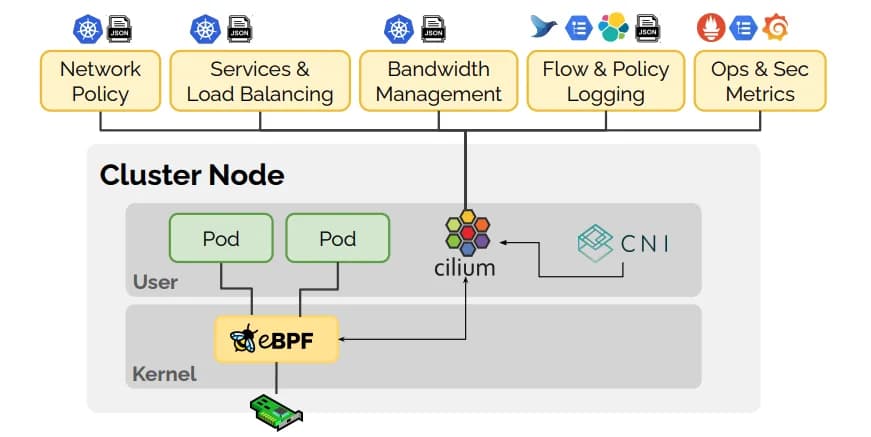
Le projet Cilium a fait d'eBPF la base d'un plugin réseau (CNI) pour Kubernetes, qui assure en un seul composant la connectivité, l'équilibrage de charge, la sécurité et l'observabilité. Créé par Isovalent (aujourd'hui rattaché à Cisco), il est un projet gradué de la Cloud Native Computing Foundation (CNCF) et il est devenu la couche réseau par défaut ou proposée en option chez les principaux fournisseurs : Dataplane V2 sur GKE, Azure CNI Powered by Cilium sur AKS, et compatibilité avec Amazon EKS, où il peut remplacer le CNI par défaut.
Dans cet article, nous allons d'abord comprendre ce qu'est eBPF, puis voir comment Cilium remplace kube-proxy, étudier ses Network Policies de la couche 3 à la couche 7, découvrir l'observabilité avec Hubble et le mode service mesh sans sidecar, avant de détailler une installation avec Helm.
Comprendre eBPF
eBPF (extended Berkeley Packet Filter) est un mécanisme du noyau Linux qui permet de charger de petits programmes dans le noyau et de les attacher à des événements : arrivée d'un paquet réseau, appel système, ouverture d'un fichier, etc. Avant d'être exécuté, chaque programme est examiné par un vérificateur qui garantit qu'il ne peut pas planter le noyau (pas de boucle infinie, pas d'accès mémoire illégal). Il est ensuite compilé à la volée en code machine natif.
Cette approche change la manière d'étendre le noyau. Auparavant, ajouter une fonctionnalité réseau ou de sécurité imposait de modifier le noyau lui-même, avec des années de délai, ou de charger un module risqué. Avec eBPF, on déploie la logique à chaud, sur des machines en production, avec un coût très faible.
- Programmes : du code écrit en C ou en Rust, compilé en bytecode eBPF, puis chargé dans le noyau.
- Hooks : les points d'attache des programmes, comme XDP (au plus près de la carte réseau), tc (contrôle du trafic) ou les sockets.
- Maps : des structures de données partagées entre le noyau et l'espace utilisateur, qui servent par exemple de tables de routage ou de compteurs.
- Vérificateur : la garantie de sûreté qui rend eBPF acceptable en production.
La mascotte d'eBPF est une abeille, un clin d'œil à son nom et à l'activité intense qui se déroule discrètement dans la ruche du noyau. C'est sur cette base que Cilium construit toute sa pile réseau.
Pourquoi Cilium s'impose sur Kubernetes
Un cluster Kubernetes délègue le réseau des Pods à un plugin CNI. Pendant longtemps, les solutions reposaient sur iptables, un système de règles chaînées conçu bien avant les conteneurs. Le temps de traitement d'un paquet croît avec le nombre de règles, et le nombre de règles croît avec le nombre de services : sur de grands clusters, cela dégrade les performances et rend la mise à jour des règles lente.
Cilium installe sur chaque nœud un agent qui compile et charge des programmes eBPF au niveau du noyau. Les décisions de routage, d'équilibrage et de filtrage s'appuient sur des tables de hachage (les maps) dont le temps d'accès ne dépend pas du nombre de services. Les identités de sécurité sont attribuées aux Pods à partir de leurs labels Kubernetes plutôt que de leurs adresses IP, ce qui reste valable quand les Pods sont recréés et changent d'adresse.
Voici les principaux domaines couverts par Cilium :
| Domaine | Fonctionnalité Cilium | Ce que cela remplace |
|---|---|---|
| Connectivité | CNI eBPF, routage natif ou overlay | Flannel, Calico en mode iptables |
| Load balancing | Service eBPF, Maglev, DSR | kube-proxy |
| Sécurité | Network Policies L3 à L7, chiffrement | Règles iptables, proxys applicatifs |
| Observabilité | Hubble | Captures de paquets, outils tiers |
Remplacer kube-proxy
Par défaut, kube-proxy traduit les Services Kubernetes en règles iptables ou IPVS sur chaque nœud. Cilium peut s'en passer complètement avec l'option kubeProxyReplacement. Les accès aux Services ClusterIP, NodePort et LoadBalancer sont alors gérés par des programmes eBPF attachés au plus bas niveau, avec une résolution des Services effectuée dès la socket quand le trafic reste dans le cluster, ce qui évite une traduction d'adresse par paquet.
Les bénéfices sont concrets : une latence plus faible, une mise à jour quasi instantanée lors de l'ajout d'un Service, un équilibrage de charge de type Maglev pour les accès externes et la préservation de l'adresse IP source des clients. Le remplacement suppose un noyau Linux récent (la documentation officielle indique les versions minimales) et la déclaration de l'adresse de l'API server, puisque kube-proxy n'est plus là pour la fournir. Le principe de l'équilibrage de charge reste le même, seule l'implémentation change.
Les Network Policies de la couche 3 à la couche 7
Par défaut, tous les Pods d'un cluster Kubernetes peuvent se parler. Les NetworkPolicy standard permettent de restreindre ce trafic par labels, namespaces et ports, aux couches 3 et 4. Cilium respecte cette ressource native et la complète avec ses propres CRD, CiliumNetworkPolicy et CiliumClusterwideNetworkPolicy, qui vont beaucoup plus loin.
- Couche 3 et 4 : filtrage par identité (labels), CIDR, ports et protocoles, avec une règle de refus par défaut.
- Couche 7 : filtrage des requêtes HTTP (méthode, chemin), gRPC, Kafka ou DNS, grâce à un proxy Envoy intégré qui n'est sollicité que pour le trafic concerné.
- FQDN : autorisation de sorties vers des noms de domaine plutôt que des plages d'adresses, utile pour les API externes.
- Politiques à l'échelle du cluster : règles communes appliquées à tous les namespaces.
L'exemple suivant n'autorise le service frontend qu'à lire l'API catalog : seules les requêtes GET sur /api/products passent, toute autre méthode est refusée.
apiVersion: cilium.io/v2
kind: CiliumNetworkPolicy
metadata:
  name: catalog-lecture-seule
  namespace: boutique
spec:
  # Pods ciblés par la politique
  endpointSelector:
    matchLabels:
      app: catalog
  ingress:
    - fromEndpoints:
        - matchLabels:
            app: frontend
      toPorts:
        - ports:
            - port: "8080"
              protocol: TCP
          rules:
            http:
              # Seule la lecture du catalogue est autorisée
              - method: "GET"
                path: "/api/products.*"
Dès qu'une règle d'entrée sélectionne un Pod, tout le trafic non listé vers ce Pod est refusé. Cette logique de moindre privilège est un pilier de l'approche Zero Trust : on ne fait confiance à aucun flux par défaut, y compris à l'intérieur du cluster. Le filtrage L7 évite aussi de déployer un proxy applicatif dédié pour des règles simples de contrôle d'accès.
Hubble : observer le réseau
Savoir qui communique avec qui est souvent le premier obstacle du diagnostic réseau sur Kubernetes. Hubble est la couche d'observabilité de Cilium. Comme les programmes eBPF voient déjà chaque paquet, Hubble en tire des flux enrichis de l'identité Kubernetes (Pod, namespace, service) sans rien instrumenter dans les applications.
Hubble se compose de plusieurs éléments :
- Hubble (dans l'agent) : collecte les flux de chaque nœud.
- Hubble Relay : agrège les flux de tous les nœuds pour offrir une vue de l'ensemble du cluster.
- Hubble CLI : interroge les flux en ligne de commande, avec des filtres par Pod, verdict ou protocole.
- Hubble UI : affiche une carte des dépendances entre services, en temps réel.
- Métriques : export vers Prometheus pour suivre les requêtes, les erreurs DNS ou les paquets abandonnés.
Un cas d'usage typique : une requête échoue après l'ajout d'une politique. Avec la commande hubble observe --verdict DROPPED --namespace boutique, on voit immédiatement quel flux est refusé et quelle règle en est la cause, là où l'analyse de journaux iptables aurait demandé bien plus de temps. Hubble s'intègre aussi à la résolution de noms du cluster : le suivi des requêtes DNS permet de repérer les problèmes que l'on rencontre avec CoreDNS.
Service mesh sans sidecar
Un service mesh ajoute chiffrement, authentification, routage avancé et métriques entre les services. Le modèle classique, popularisé par Istio, injecte un proxy sidecar dans chaque Pod : cela multiplie les conteneurs, consomme de la mémoire et du CPU, et complique les mises à jour.
Cilium propose un mode service mesh sans sidecar. Le trafic L3 et L4 est traité par eBPF dans le noyau, et lorsqu'un traitement L7 est nécessaire (routage HTTP, observabilité applicative), il est confié à un proxy Envoy exécuté une fois par nœud plutôt qu'une fois par Pod. L'authentification mutuelle entre workloads repose sur des identités de type SPIFFE. Cilium implémente aussi la Gateway API pour gérer l'entrée du trafic dans le cluster.
| Critère | Sidecar (Istio classique) | Cilium sans sidecar |
|---|---|---|
| Proxy | Un Envoy par Pod | Un Envoy par nœud, eBPF pour L3/L4 |
| Surcoût mémoire | Proportionnel au nombre de Pods | Réduit, indépendant du nombre de Pods |
| Mise à jour | Redémarrage des Pods applicatifs | Mise à jour de l'agent sur le nœud |
| Fonctionnalités L7 | Très complètes | Plus restreintes selon les cas |
Ce choix n'est pas anodin : les fonctionnalités L7 d'Istio restent plus riches, et le mode ambient d'Istio explore lui aussi une approche sans sidecar. Pour une équipe qui cherche surtout du chiffrement, de la politique réseau et de l'observabilité, Cilium offre un compromis simple, avec un seul composant à exploiter.
Installer Cilium avec Helm
L'installation de référence passe par Helm, avec le dépôt officiel de Cilium. Sur un cluster neuf, sans CNI ni kube-proxy, il faut indiquer à Cilium comment joindre l'API server, puisque aucun Service Kubernetes n'est encore disponible.
# Ajout du dépôt Helm officiel de Cilium
helm repo add cilium https://helm.cilium.io/
helm repo update

# Installation avec remplacement de kube-proxy et Hubble activé
helm install cilium cilium/cilium \
  --version 1.19.4 \
  --namespace kube-system \
  --set kubeProxyReplacement=true \
  --set k8sServiceHost=<ADRESSE_API_SERVER> \
  --set k8sServicePort=6443 \
  --set hubble.relay.enabled=true \
  --set hubble.ui.enabled=true

# Vérification de l'état de Cilium
cilium status --wait
La commande cilium status, fournie par la CLI Cilium, attend que l'agent, l'opérateur et Hubble soient prêts. On peut ensuite lancer cilium connectivity test pour valider la connectivité entre Pods et l'application des politiques. Sur les clusters managés, la démarche diffère : GKE active Cilium avec l'option Dataplane V2 à la création du cluster, et AKS avec le mode Azure CNI Powered by Cilium. Il faut alors suivre la documentation du fournisseur plutôt que d'installer le chart soi-même.
Pour une mise à jour de version mineure, la documentation officielle recommande de relire les notes de version, de passer d'abord sur le dernier correctif de la version courante, et d'éviter l'option --reuse-values. Versionnez le fichier de valeurs Helm dans Git pour garder une configuration reproductible.
À découvrir : notre formation DevOps Engineer
Conclusion
Cilium montre ce que permet eBPF lorsqu'on l'applique au réseau Kubernetes : un plan de données programmable dans le noyau, rapide et sûr, qui réunit la connectivité, l'équilibrage de charge, la sécurité et l'observabilité. Le remplacement de kube-proxy, les politiques de la couche 3 à la couche 7 et Hubble répondent aux limites de l'approche iptables, tandis que le mode sans sidecar propose une alternative plus légère au service mesh traditionnel.
Son adoption par GKE, AKS et, de façon optionnelle, EKS, ainsi que son statut de projet gradué de la CNCF, en font un choix solide pour les nouveaux clusters. Il demande toutefois de maîtriser des prérequis (version du noyau, configuration de l'API server) et de bien choisir son niveau de fonctionnalités, notamment pour le service mesh.
Pour les ingénieurs DevOps et les Platform Engineers, comprendre eBPF et Cilium devient une compétence différenciante : c'est la base sur laquelle se construisent aujourd'hui le réseau, la sécurité et l'observabilité des plateformes Kubernetes.