Speculative Decoding : accélérer l'inférence des LLM
Générer du texte avec un LLM reste un processus séquentiel : un token à la fois, chacun nécessitant une passe complète du modèle. Sur les grands modèles, ce goulot d'étranglement n'est pas lié à la puissance de calcul mais à la bande passante mémoire du GPU, qui doit relire l'intégralité des poids à chaque token produit. Résultat : les unités de calcul passent l'essentiel de leur temps à attendre les données, et la latence perçue par l'utilisateur s'en ressent directement.
Équipe Blent
Publié le · 11 min de lecture
Dans cet article
Générer du texte avec un LLM reste un processus séquentiel : un token à la fois, chacun nécessitant une passe complète du modèle. Sur les grands modèles, ce goulot d'étranglement n'est pas lié à la puissance de calcul mais à la bande passante mémoire du GPU, qui doit relire l'intégralité des poids à chaque token produit. Résultat : les unités de calcul passent l'essentiel de leur temps à attendre les données, et la latence perçue par l'utilisateur s'en ressent directement.
C'est sur ce constat qu'est née une technique devenue standard dans les moteurs d'inférence modernes : le speculative decoding, ou décodage spéculatif. Proposée en 2022 par des équipes de Google, puis indépendamment par DeepMind, l'idée consiste à faire deviner plusieurs tokens à l'avance par un mécanisme peu coûteux, puis à les faire vérifier en une seule passe par le grand modèle. Le texte obtenu suit exactement la même distribution que celle du modèle seul : on gagne en vitesse sans rien sacrifier en qualité.
Pour un AI Engineer qui sert des LLM en production, c'est l'un des rares leviers d'optimisation « gratuits » en termes de qualité. Dans cet article, nous allons expliquer le principe et ses garanties mathématiques, passer en revue les principales variantes (modèle brouillon, Medusa, EAGLE, n-gram lookup), puis voir comment le mettre en œuvre dans vLLM et quels compromis il impose avec le batching.
Pourquoi le décodage est lent
Pour comprendre l'intérêt de la technique, il faut distinguer les deux phases de l'inférence d'un Transformer. Le prefill traite le prompt en parallèle : tous les tokens d'entrée passent ensemble dans le modèle, ce qui sature les unités de calcul. Le decode génère ensuite la réponse token par token, et chaque étape ne traite qu'un seul nouveau token.
Pendant le decode, le GPU doit charger l'ensemble des poids du modèle depuis sa mémoire pour ne produire qu'un seul token. L'intensité arithmétique (le nombre d'opérations par octet lu) est très faible : on dit que cette phase est memory-bound. Vérifier 5 tokens ou 1 seul coûte presque le même temps, puisque le coût dominant est la lecture des poids et non les multiplications de matrices.
C'est cette asymétrie que le speculative decoding exploite. Plutôt que de produire un token par passe, on soumet au grand modèle plusieurs tokens candidats d'un coup et on lui demande de les valider. Une passe de vérification de plusieurs tokens coûte à peine plus qu'une passe classique, mais peut en faire avancer plusieurs.
| Phase | Nature du goulot | Parallélisme | Levier d'optimisation |
|---|---|---|---|
| Prefill | Calcul (compute-bound) | Tous les tokens du prompt | Quantization, FlashAttention |
| Decode | Mémoire (memory-bound) | Un token par passe | Speculative decoding |
| Batch élevé | Retour vers le calcul | Plusieurs requêtes | Continuous batching |
Principe et garanties mathématiques
Le schéma général repose sur deux acteurs : un modèle brouillon (draft model), petit et rapide, et le modèle cible (target model), le grand modèle dont on veut reproduire la distribution. Chaque cycle se déroule en trois temps :
- Proposition : le brouillon génère de façon autorégressive tokens candidats, ce qui est rapide car il est petit
- Vérification : le modèle cible évalue en une seule passe parallèle les positions proposées, et calcule sa propre distribution à chacune
- Acceptation : les tokens candidats sont acceptés tant qu'ils sont compatibles avec le modèle cible, et le premier rejet est corrigé par un token tiré directement depuis le modèle cible
Même lorsque tous les candidats sont rejetés, le cycle produit au moins un token valide, issu de la passe de vérification. Dans le meilleur cas, il en produit pour le prix d'une seule passe du grand modèle.
Pourquoi la qualité est préservée
La garantie centrale tient à la règle d'acceptation. Notons la probabilité attribuée au token par le brouillon, et celle du modèle cible. Un token proposé est accepté avec la probabilité :
Si le modèle cible juge le token au moins aussi probable que le brouillon, il est toujours accepté. Sinon, il est accepté proportionnellement. En cas de rejet, le token de remplacement est tiré dans la distribution résiduelle, c'est-à-dire tronquée à zéro puis renormalisée. Les auteurs démontrent que cette procédure produit exactement des échantillons de : la distribution de sortie est identique à celle du modèle cible seul.
En décodage glouton (température nulle), la règle se simplifie : un token est accepté s'il correspond à l'argmax du modèle cible, sinon il est remplacé par celui-ci. La sortie est alors strictement identique à celle du décodage classique, aux différences numériques près liées à l'exécution en batch.
Quel gain espérer ?
Le gain dépend du taux d'acceptation , la probabilité moyenne qu'un token proposé soit accepté. Avec tokens proposés par cycle, le nombre moyen de tokens produits par passe du modèle cible vaut :
Avec et , on obtient environ 3,4 tokens par passe. Il faut cependant retrancher le coût des propositions du brouillon : un brouillon trop lent annule le bénéfice, et un brouillon trop faible fait chuter . Dans les publications d'origine, les accélérations mesurées se situent entre 2 et 3 fois sur des modèles de grande taille, selon la tâche.
Les variantes : du brouillon à EAGLE
Le principe est unique, mais la façon de produire les candidats varie beaucoup. Chaque approche arbitre différemment entre simplicité de mise en place, taux d'acceptation et surcoût mémoire.
Modèle brouillon séparé
La version historique utilise un petit modèle indépendant, par exemple un modèle de 1 milliard de paramètres pour accélérer un modèle de 70 milliards. Les contraintes sont réelles : le brouillon doit partager le même tokenizer (voir notre article sur la tokenization) que la cible, et idéalement avoir été entraîné sur des données proches. Il consomme aussi de la VRAM et ajoute un second modèle à déployer. Les small language models d'une même famille que le modèle cible sont les candidats naturels.
Medusa : plusieurs têtes de prédiction
Medusa supprime le modèle brouillon séparé. Elle ajoute au modèle cible plusieurs têtes de décodage supplémentaires, chacune chargée de prédire un token à une position future (+1, +2, +3, etc.) à partir de l'état caché courant. Les combinaisons candidates sont organisées en arbre et vérifiées simultanément grâce à un masque d'attention adapté (tree attention). Seules les têtes sont entraînées, ce qui reste léger, mais chaque tête prédit sans connaître les tokens que les précédentes ont choisis, ce qui limite le taux d'acceptation.
EAGLE : prédire au niveau des représentations
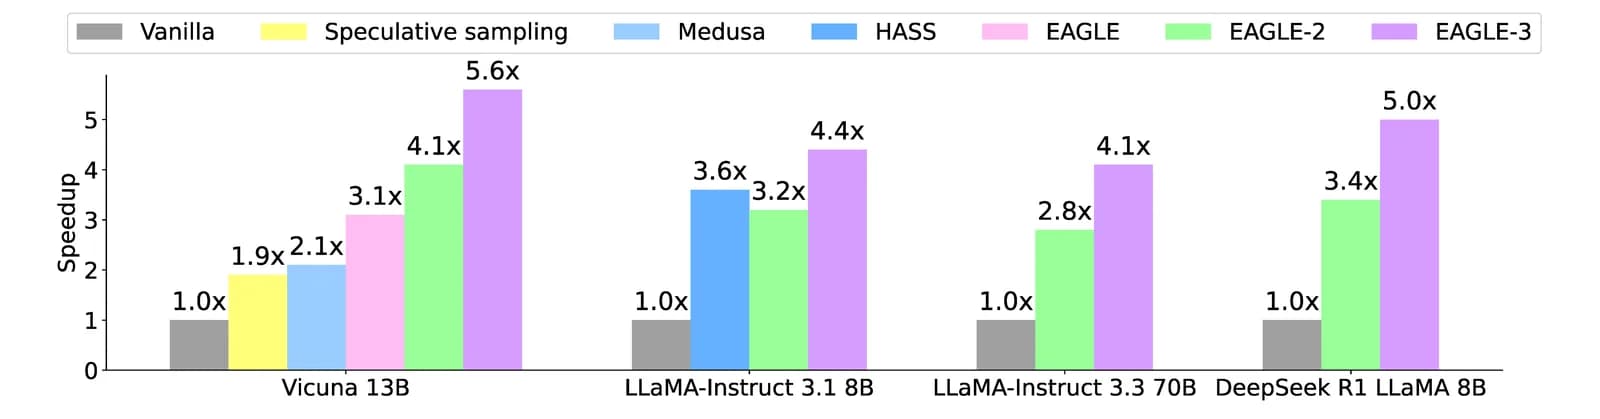
EAGLE (Extrapolation Algorithm for Greater Language-model Efficiency) corrige ce défaut. Au lieu de prédire des tokens, un petit module autorégressif extrapole les états cachés du modèle cible, avant la dernière couche, puis les convertit en tokens avec la tête de langage du modèle. Ce travail au niveau des représentations est plus régulier que celui sur les tokens, ce qui améliore nettement l'acceptation. Les versions suivantes (EAGLE-2 avec arbre de candidats dynamique, puis EAGLE-3) ont encore augmenté les gains : les auteurs annoncent jusqu'à 3 à 6 fois de vitesse par rapport au décodage classique selon la version et le modèle, tout en conservant la distribution de sortie du modèle cible.
N-gram lookup et variantes sans modèle
Certaines tâches produisent des textes qui répètent le contexte : résumé, extraction d'informations, réécriture de code, RAG. Le n-gram lookup (aussi appelé prompt lookup decoding) exploite cette redondance : on cherche dans le prompt la dernière séquence de tokens générés, et on propose comme candidats les tokens qui la suivaient. Aucun modèle, aucun entraînement, aucune VRAM supplémentaire. Le gain est nul sur une génération libre, mais très appréciable sur des cas d'usage de RAG ou d'édition de code.
| Méthode | Entraînement requis | Surcoût mémoire | Taux d'acceptation | Cas idéal |
|---|---|---|---|---|
| Modèle brouillon | Aucun si modèle existant | Un second modèle | Moyen à bon | Famille de modèles disponible |
| Medusa | Têtes à entraîner | Faible | Moyen | Modèle fine-tuné maison |
| EAGLE / EAGLE-3 | Module à entraîner | Faible | Élevé | Production à grande échelle |
| N-gram lookup | Aucun | Nul | Variable | Contexte répétitif (RAG, code) |
Mise en œuvre dans vLLM
vLLM intègre plusieurs méthodes de décodage spéculatif, configurées par un unique objet speculative_config. Le champ method désigne la stratégie (draft_model, ngram, eagle3, mtp, suffix, etc.), et num_speculative_tokens fixe le nombre de tokens proposés par cycle.
Pour lancer un serveur avec un modèle brouillon séparé, la configuration se passe en JSON sur la ligne de commande :
# Serveur avec un petit modèle brouillon de la même famille que la cible
vllm serve meta-llama/Llama-3.1-70B-Instruct \
    --tensor-parallel-size 4 \
    --speculative-config '{
        "method": "draft_model",
        "model": "meta-llama/Llama-3.2-1B-Instruct",
        "num_speculative_tokens": 5
    }'
Le serveur reste compatible avec l'API OpenAI : les clients n'ont rien à modifier, seule la latence change. Pour une approche sans modèle auxiliaire, le n-gram lookup s'active en Python avec l'API hors ligne :
from vllm import LLM, SamplingParams

# Décodage spéculatif par n-gram : aucun modèle supplémentaire à charger
llm = LLM(
    model="meta-llama/Llama-3.1-8B-Instruct",
    speculative_config={
        "method": "ngram",
        "num_speculative_tokens": 4,
        "prompt_lookup_min": 2,
        "prompt_lookup_max": 5,
    },
)

prompt = "Résume le texte suivant en reprenant les chiffres clés : ..."
params = SamplingParams(temperature=0.0, max_tokens=256)
sortie = llm.generate([prompt], params)
print(sortie[0].outputs[0].text)
Les paramètres prompt_lookup_min et prompt_lookup_max délimitent la taille des séquences recherchées dans le contexte. Pour EAGLE, on indique dans model le checkpoint de la tête pré-entraînée correspondant au modèle cible, avec method fixé à eagle3. Les noms exacts évoluant d'une version à l'autre, il faut toujours se référer à la documentation de la version installée. Pour mesurer l'effet réel, vLLM expose des métriques de taux d'acceptation, à surveiller avant tout déploiement.
Compromis avec le batching
Le speculative decoding n'est pas un gain universel. Son avantage repose sur le fait que le GPU est sous-utilisé pendant le decode. Or le continuous batching cherche précisément à combler cet espace libre en traitant de nombreuses requêtes à la fois.
À faible charge, le batch est petit, le GPU est memory-bound et la vérification de tokens supplémentaires est quasiment gratuite : c'est le régime où les gains de latence sont les plus forts. À charge élevée, le batch grossit, le calcul devient le facteur limitant, et chaque token spéculatif rejeté représente du travail réellement gaspillé. Le gain peut alors s'effondrer, voire devenir négatif.
Plusieurs points de vigilance en découlent :
- Régime de charge : les méthodes à base de modèle (brouillon, EAGLE, MTP) apportent le plus à faible ou moyen trafic, alors que les méthodes légères comme le n-gram pèsent peu sur la charge en heure de pointe
- Latence contre débit : la technique optimise d'abord la latence par requête (temps entre tokens), pas forcément le débit global du serveur
- Tâche et température : à température élevée ou sur des tâches créatives, l'acceptation baisse, alors qu'elle est excellente sur le code, l'extraction ou les sorties structurées
- Mémoire : un brouillon séparé ou un cache KV supplémentaire réduit la place disponible pour les requêtes concurrentes
- Reproductibilité : en batch, de petites différences numériques peuvent modifier les logprobs, même si la distribution théorique reste exacte
La démarche recommandée est donc empirique : mesurer le temps par token et le taux d'acceptation sur un échantillon représentatif de votre trafic, à plusieurs niveaux de concurrence, avant d'activer l'option par défaut. Les équipes qui suivent leurs coûts d'inférence dans une démarche de FinOps pour les LLM y trouvent un levier complémentaire à la quantization, les deux techniques se combinant.
À découvrir : notre formation LLM Engineering
Conclusion
Le speculative decoding transforme un défaut structurel du décodage autorégressif, la sous-utilisation du GPU, en opportunité. En faisant proposer plusieurs tokens par un mécanisme léger et en les faisant valider en une passe par le grand modèle, il réduit la latence sans modifier la distribution de sortie, une garantie que peu d'optimisations peuvent revendiquer.
Les variantes se choisissent selon le contexte : un modèle brouillon quand une famille de modèles est disponible, Medusa ou EAGLE pour des gains plus élevés au prix d'un petit entraînement, le n-gram lookup pour les tâches qui recopient le contexte. Dans tous les cas, le bénéfice dépend du taux d'acceptation et de la charge du serveur, ce qui impose de mesurer plutôt que supposer.
À mesure que les modèles grossissent et que les agents et les modèles de raisonnement enchaînent des générations de plus en plus longues, la latence d'inférence devient un enjeu central. Maîtriser le décodage spéculatif et ses compromis avec le batching fait désormais partie des compétences différenciantes d'un AI Engineer chargé de servir des LLM à l'échelle.