Feast : mettre en place un Feature Store open source
Un modèle de Machine Learning n'est jamais meilleur que les features qui l'alimentent, et ces features sont souvent recalculées de manière différente par chaque équipe, chaque notebook et chaque service de prédiction. Résultat : des écarts entre l'entraînement et la production, des calculs dupliqués et des fuites de données difficiles à détecter. Le Feature Store répond à ce problème en centralisant la définition, le stockage et la diffusion des features.
Équipe Blent
Publié le · 10 min de lecture
Dans cet article
Un modèle de Machine Learning n'est jamais meilleur que les features qui l'alimentent, et ces features sont souvent recalculées de manière différente par chaque équipe, chaque notebook et chaque service de prédiction. Résultat : des écarts entre l'entraînement et la production, des calculs dupliqués et des fuites de données difficiles à détecter. Le Feature Store répond à ce problème en centralisant la définition, le stockage et la diffusion des features.
Comment s'assurer que la variable « nombre de commandes sur 30 jours » est calculée de la même façon dans un notebook de Data Scientist et dans une API qui répond en quelques millisecondes ? Comment éviter que dix équipes réécrivent dix fois la même transformation ? Comment reconstituer l'état exact des données à la date d'un événement passé ? Ces questions deviennent centrales dès que l'on industrialise des modèles, et c'est précisément le terrain du Feature Store.
Feast (Feature Store) est aujourd'hui la référence open source du domaine. Il ne cherche pas à remplacer votre entrepôt de données ni votre moteur de calcul : il s'appuie sur l'infrastructure existante pour servir les mêmes features en batch et en temps réel. Dans cet article, nous allons expliquer à quoi sert un Feature Store, détailler l'architecture de Feast avec un exemple de code, puis le situer face aux offres managées de Databricks, SageMaker et Vertex AI.
À quoi sert un Feature Store ?
Le Feature Engineering consiste à transformer des données brutes en variables exploitables par un modèle. Sans outillage dédié, ce travail est dispersé : une requête SQL pour l'entraînement, un script Python pour l'inférence, parfois un calcul réimplémenté dans un autre langage côté application. Un Feature Store est la couche qui rassemble ces features dans un catalogue versionné, avec un stockage adapté à chaque usage.
Cohérence entre entraînement et inférence
Le training-serving skew désigne l'écart entre les features vues à l'entraînement et celles reçues en production. Il provient le plus souvent de deux implémentations distinctes de la même logique : une moyenne glissante calculée en SQL d'un côté, approchée en Python de l'autre, avec des arrondis, des fuseaux horaires ou des valeurs manquantes traités différemment. Le modèle se dégrade alors sans qu'aucune erreur technique ne soit levée.
Avec un Feature Store, la définition d'une feature est écrite une seule fois. Les mêmes objets servent à produire le jeu d'entraînement (lecture historique) et à répondre aux requêtes en ligne (lecture à faible latence). La cohérence n'est plus une affaire de discipline entre équipes, elle est garantie par l'architecture.
Réutilisation et gouvernance des features
Une feature comme « montant moyen des achats par client » est utile à la fois pour un modèle de détection de fraude, de recommandation et d'attrition. Dans un Feature Store, elle est découvrable, documentée et réutilisable par toutes les équipes. Cela apporte plusieurs bénéfices :
- Moins de duplication : une feature est calculée et stockée une fois, puis partagée.
- Traçabilité : chaque feature possède un propriétaire, une source, des tags et une description.
- Mise en production accélérée : un nouveau modèle réutilise un catalogue existant au lieu de repartir de zéro.
- Contrôle d'accès : on sait quels modèles consomment quelles données, ce qui facilite les audits.
Point-in-time correctness
C'est la propriété la plus subtile, et sans doute la plus précieuse. Pour entraîner un modèle, on associe à chaque exemple (par exemple une commande passée le 12 avril à 10 h 59) les valeurs des features telles qu'elles étaient à cet instant précis, et non leurs valeurs actuelles. Utiliser des valeurs plus récentes revient à donner au modèle une information qu'il n'aurait pas eue en production : c'est une fuite de données (data leakage), qui produit des métriques flatteuses en test et des performances décevantes en réel.
Le Feature Store réalise automatiquement cette jointure temporelle (point-in-time join) : pour chaque ligne, il retient la dernière valeur de la feature connue avant l'horodatage de l'événement, dans la limite d'une durée de validité. Écrire cette logique à la main en SQL est fastidieux et source d'erreurs, d'où l'intérêt de la déléguer à l'outil.
À lire : découvrez notre formation MLOps
L'architecture de Feast
Feast est une bibliothèque Python accompagnée d'une CLI. Son architecture repose sur quatre briques principales qui s'articulent autour de vos définitions de features.
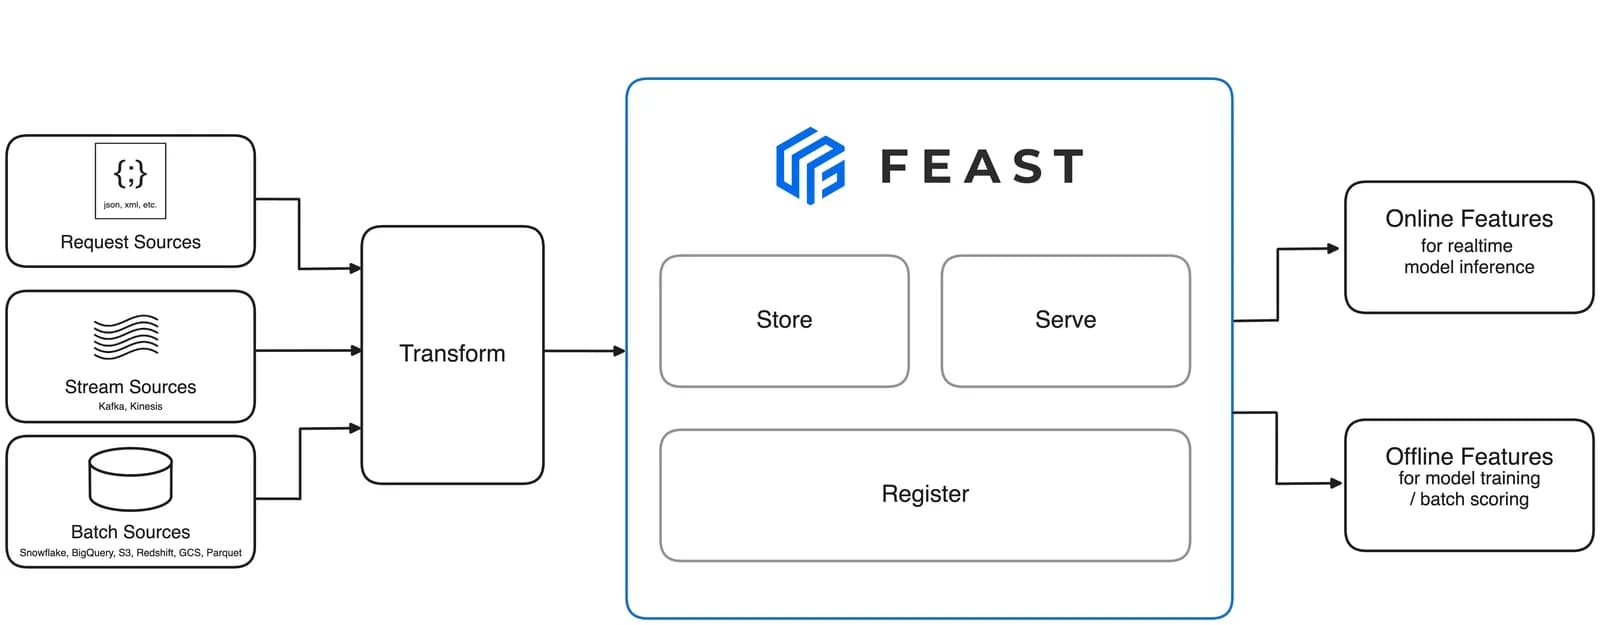
Registre, offline store et online store
Le registre (registry) est le catalogue central : il contient la définition des entités, des sources de données, des vues de features et des services de features. Par défaut, il s'agit d'un simple fichier, mais il peut être remplacé par un registre adossé à une base SQL, plus adapté à un usage en équipe.
L'offline store est l'espace où vivent les données historiques. Il sert à générer les jeux d'entraînement et à calculer les jointures point-in-time. Feast ne stocke pas ces données lui-même : il s'appuie sur des moteurs existants, comme des fichiers Parquet en local, un Data Warehouse (BigQuery, Snowflake, Redshift) ou Spark.
L'online store contient uniquement la dernière valeur connue de chaque feature, indexée par entité, pour une lecture en quelques millisecondes. On y retrouve des bases clé-valeur comme Redis ou DynamoDB, mais aussi SQLite pour le développement local.
| Composant | Rôle | Contenu | Exemples de technologies |
|---|---|---|---|
| Registre | Catalogue des définitions | Entités, vues, services | Fichier, base SQL |
| Offline store | Historique pour l'entraînement | Toutes les valeurs horodatées | Parquet, BigQuery, Snowflake, Spark |
| Online store | Service à faible latence | Dernière valeur par entité | Redis, DynamoDB, SQLite |
| Matérialisation | Synchronisation offline vers online | Valeurs récentes | Commandes feast materialize |
La liste exacte des backends pris en charge évolue d'une version à l'autre : la documentation officielle reste la source à consulter avant de choisir une combinaison.
Matérialisation
La matérialisation est l'opération qui copie les valeurs les plus récentes de l'offline store vers l'online store. On l'exécute à intervalle régulier, typiquement depuis un orchestrateur comme Apache Airflow, pour que les features servies en ligne restent fraîches. Pour des données en flux, par exemple issues de Kafka, Feast propose également un mécanisme de poussée (push) qui écrit directement dans l'online store.
Définir des features avec Feast
Le point de départ est un dépôt de features, composé d'un fichier feature_store.yaml qui configure le projet, et d'un fichier Python de définitions. Voici une configuration minimale pour un usage local :
project: my_project
# Registre sous forme de fichier (remplaçable par un registre SQL)
registry: data/registry.db
provider: local
online_store:
  type: sqlite
  path: data/online_store.db
entity_key_serialization_version: 3
Les définitions décrivent l'entité (la clé métier), la source de données et la vue de features :
from datetime import timedelta

from feast import Entity, FeatureService, FeatureView, Field, FileSource
from feast.types import Float32, Int64

# Entité : la clé de jointure métier
driver = Entity(name="driver", join_keys=["driver_id"])

# Source : un fichier Parquet horodaté
driver_stats_source = FileSource(
    name="driver_hourly_stats_source",
    path="data/driver_stats.parquet",
    timestamp_field="event_timestamp",
    created_timestamp_column="created",
)

# Vue de features : schéma, durée de validité (ttl) et source
driver_stats_fv = FeatureView(
    name="driver_hourly_stats",
    entities=[driver],
    ttl=timedelta(days=1),
    schema=[
        Field(name="conv_rate", dtype=Float32),
        Field(name="acc_rate", dtype=Float32),
        Field(name="avg_daily_trips", dtype=Int64),
    ],
    online=True,
    source=driver_stats_source,
    tags={"team": "driver_performance"},
)

# Service de features : l'ensemble consommé par un modèle donné
driver_activity_v1 = FeatureService(
    name="driver_activity_v1",
    features=[driver_stats_fv],
)
Le paramètre ttl fixe la durée pendant laquelle une valeur reste utilisable lors de la jointure point-in-time. Le FeatureService regroupe les features d'un modèle : c'est lui que l'on versionne lorsque le modèle évolue. On enregistre ensuite ces définitions dans le registre, puis on matérialise les valeurs récentes vers l'online store :
feast apply

CURRENT_TIME=$(date -u +"%Y-%m-%dT%H:%M:%S")
feast materialize-incremental $CURRENT_TIME
À découvrir : notre formation MLOps
Récupérer les features : entraînement et production
Une fois les features définies, deux méthodes couvrent tous les usages, avec les mêmes noms de features dans les deux cas.
Lecture historique pour l'entraînement
Pour constituer un jeu d'entraînement, on fournit un DataFrame d'entités avec leurs horodatages et leur cible. Feast réalise la jointure point-in-time et renvoie les features correspondantes :
from datetime import datetime

import pandas as pd
from feast import FeatureStore

# Chaque ligne porte la clé d'entité, l'instant de l'événement et la cible
entity_df = pd.DataFrame.from_dict(
    {
        "driver_id": [1001, 1002, 1003],
        "event_timestamp": [
            datetime(2021, 4, 12, 10, 59, 42),
            datetime(2021, 4, 12, 8, 12, 10),
            datetime(2021, 4, 12, 16, 40, 26),
        ],
        "label_driver_reported_satisfaction": [1, 5, 3],
    }
)

store = FeatureStore(repo_path=".")

training_df = store.get_historical_features(
    entity_df=entity_df,
    features=[
        "driver_hourly_stats:conv_rate",
        "driver_hourly_stats:acc_rate",
        "driver_hourly_stats:avg_daily_trips",
    ],
).to_df()
Le résultat est un DataFrame prêt à être utilisé pour entraîner un modèle, dont les versions peuvent être suivies avec un outil comme MLflow.
Lecture en ligne pour l'inférence
En production, l'API de prédiction interroge l'online store avec uniquement la clé de l'entité. La latence est faible, car seule la dernière valeur est lue :
from feast import FeatureStore

store = FeatureStore(repo_path=".")

feature_vector = store.get_online_features(
    features=[
        "driver_hourly_stats:conv_rate",
        "driver_hourly_stats:acc_rate",
        "driver_hourly_stats:avg_daily_trips",
    ],
    entity_rows=[{"driver_id": 1004}, {"driver_id": 1005}],
).to_dict()
Les noms de features étant identiques dans les deux appels, le code d'entraînement et le code d'inférence consomment strictement la même définition. C'est ce qui supprime le training-serving skew à la source.
Feast face aux offres managées
Feast n'est pas la seule option. Les grandes plateformes proposent leur propre Feature Store, intégré à leur écosystème.
| Solution | Type | Points forts | Limites |
|---|---|---|---|
| Feast | Open source | Neutre vis-à-vis du cloud, backends interchangeables | À déployer et à exploiter soi-même |
| Databricks | Managé | Intégré au catalogue Unity Catalog et aux tables Delta | Lié à la plateforme Databricks |
| SageMaker Feature Store | Managé | Intégré à l'écosystème AWS, stockage online et offline | Lié à AWS |
| Vertex AI Feature Store | Managé | S'appuie sur BigQuery pour les données | Lié à Google Cloud |
Les offres managées réduisent la charge d'exploitation et s'intègrent naturellement aux outils de la plateforme (catalogue de données, entraînement, déploiement). Elles ont en contrepartie un coût d'enfermement : changer de cloud implique de redéfinir ses features. Feast, de son côté, découple la définition des features du fournisseur d'infrastructure et permet de rester portable, mais demande de piloter soi-même le registre, les jobs de matérialisation et la supervision.
Le choix dépend donc du contexte. Une organisation déjà standardisée sur Databricks, AWS ou Google Cloud a souvent intérêt à adopter l'offre native. Une équipe multi-cloud, soumise à des contraintes de souveraineté ou souhaitant garder la maîtrise de sa stack se tournera plus volontiers vers Feast. Dans tous les cas, un Feature Store n'est pas indispensable pour un premier modèle : il devient rentable dès que plusieurs modèles partagent des features ou que l'inférence en ligne exige une parfaite cohérence avec l'entraînement.
Conclusion
Un Feature Store s'attaque à trois problèmes classiques de l'industrialisation du Machine Learning : l'écart entre l'entraînement et la production, la duplication des calculs entre équipes, et les fuites de données liées au temps. En définissant chaque feature une seule fois, puis en la servant en batch comme en temps réel, il apporte la rigueur qui manque souvent aux pipelines construits au fil de l'eau.
Feast propose une approche simple et ouverte : un registre pour le catalogue, un offline store pour l'historique, un online store pour la faible latence et la matérialisation pour les synchroniser. Quelques dizaines de lignes de Python suffisent pour obtenir une première chaîne cohérente, que l'on peut ensuite faire évoluer vers des backends plus robustes. Face aux offres de Databricks, SageMaker ou Vertex AI, c'est le compromis entre portabilité et charge d'exploitation qui guide la décision.
Maîtriser la gestion des features, l'orchestration et le déploiement des modèles est devenu une compétence différenciante pour les Machine Learning Engineers et les Data Engineers. Le Feature Store est l'une des briques qui font passer un modèle du notebook à un service fiable en production.