Ray : distribuer l'entraînement et l'inférence des modèles
Un modèle qui tenait sur un portable doit soudain s'entraîner sur dix fois plus de données, un pipeline de prétraitement met une nuit entière à s'exécuter, un service d'inférence doit absorber des pics de requêtes sur plusieurs GPU. Chaque fois, le même constat : le code Python écrit pour une machine ne passe pas à l'échelle sans une réécriture coûteuse. Ray répond à ce besoin en offrant un moteur de calcul distribué où quelques décorateurs suffisent pour répartir un programme sur un cluster.
Équipe Blent
Publié le · 12 min de lecture
Dans cet article
Un modèle qui tenait sur un portable doit soudain s'entraîner sur dix fois plus de données, un pipeline de prétraitement met une nuit entière à s'exécuter, un service d'inférence doit absorber des pics de requêtes sur plusieurs GPU. Chaque fois, le même constat : le code Python écrit pour une machine ne passe pas à l'échelle sans une réécriture coûteuse. Ray répond à ce besoin en offrant un moteur de calcul distribué où quelques décorateurs suffisent pour répartir un programme sur un cluster.
Comment paralléliser une fonction sans réécrire son application autour d'un framework imposé ? Comment partager un état (un modèle chargé en mémoire, un compteur, un cache) entre des centaines de processus ? Comment enchaîner, avec le même outil, le prétraitement des données, l'entraînement, le réglage des hyperparamètres et la mise en production ? Ces questions sont au cœur du travail des ML engineers dès que les modèles grossissent.
Ray est un framework open source, né à l'université de Berkeley et aujourd'hui maintenu par Anyscale et une large communauté. Il est utilisé pour l'entraînement et l'inférence de modèles de grande taille, notamment par des acteurs de l'IA générative. Dans cet article, nous allons présenter son architecture, parcourir ses bibliothèques Data, Train, Tune et Serve, puis voir comment le déployer sur Kubernetes avec KubeRay et le situer face à Spark.
Comprendre l'architecture de Ray
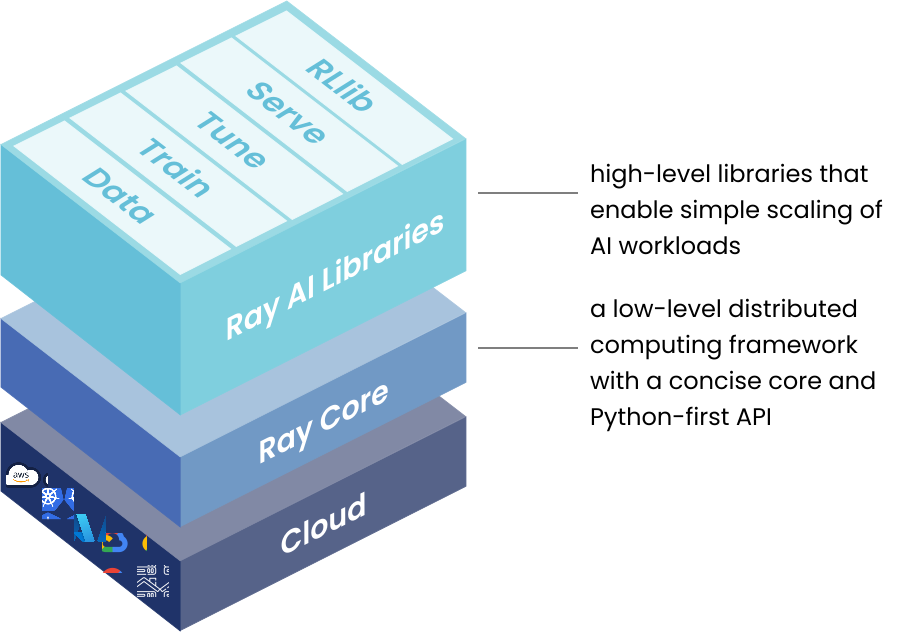
Ray est organisé en couches. Au centre, Ray Core fournit les primitives de calcul distribué. Au-dessus, des bibliothèques spécialisées couvrent le cycle de vie d'un projet de Machine Learning. Cette organisation permet d'apprendre un petit nombre de concepts, puis de les retrouver partout.
Tasks, actors et object store
Ray Core repose sur trois notions :
- Task : une fonction sans état, décorée par
@ray.remote, que Ray exécute sur n'importe quel nœud disponible du cluster. - Actor : une classe décorée par
@ray.remote, dont chaque instance vit dans un processus dédié et conserve son état entre les appels. - Object store : un stockage partagé en mémoire sur chaque nœud, qui conserve les résultats et permet de les transmettre sans copie inutile entre processus d'une même machine.
Un appel à .remote() ne bloque pas : il renvoie immédiatement une référence (ObjectRef) vers un résultat futur. Les références peuvent être passées à d'autres tasks, ce qui permet à Ray de construire un graphe de dépendances dynamique et de n'exécuter chaque étape que lorsque ses entrées sont prêtes. On ne récupère la valeur qu'avec ray.get.
import ray

ray.init()  # Démarre Ray en local ou se connecte à un cluster existant

@ray.remote
def preprocess(batch):
    """Tâche sans état : nettoie un lot de données."""
    return [x * 2 for x in batch]

@ray.remote
class ModelHolder:
    """Acteur : garde un modèle chargé une seule fois en mémoire."""

    def __init__(self):
        self.calls = 0

    def predict(self, features):
        self.calls += 1
        return sum(features)

# Quatre lots traités en parallèle sur le cluster
refs = [preprocess.remote([i, i + 1]) for i in range(4)]

holder = ModelHolder.remote()
# Les références sont passées directement à l'acteur
predictions = ray.get([holder.predict.remote(r) for r in refs])
print(predictions)
Dans cet exemple, les quatre tasks s'exécutent en parallèle, puis l'acteur consomme leurs résultats sans que le programme principal ne les rapatrie. Le pattern est le même à grande échelle : les tasks servent au calcul massivement parallèle, les actors aux ressources coûteuses à initialiser, comme un modèle chargé sur GPU.
Architecture d'un cluster
Un cluster Ray comprend un nœud head et des nœuds workers. Le head héberge les composants de gestion du cluster (dont le service de contrôle global, le GCS) et le tableau de bord. Sur chaque nœud, un processus appelé raylet gère l'ordonnancement local des tasks et l'object store. Lorsqu'une task demande des ressources (CPU, GPU, mémoire), l'ordonnanceur la place sur un nœud qui les possède.
@ray.remote(num_gpus=1)
def embed_on_gpu(texts):
    """Cette tâche ne sera placée que sur un nœud disposant d'un GPU libre."""
    ...
La déclaration explicite des ressources est l'un des points forts de Ray pour les charges d'IA : un même cluster peut mélanger des nœuds CPU pour le prétraitement et des nœuds GPU pour l'entraînement, et chaque étape atterrit au bon endroit. Les ressources personnalisées permettent aussi de cibler un type de machine précis.
À lire : découvrez notre formation MLOps
Les bibliothèques de Ray pour le Machine Learning
Les bibliothèques de Ray s'appuient toutes sur Ray Core. Elles partagent donc le même cluster, le même ordonnanceur et le même modèle de ressources, ce qui évite de jongler avec plusieurs systèmes.
| Bibliothèque | Rôle | Cas d'usage typique |
|---|---|---|
| Ray Data | Traitement de données distribué | Prétraitement, inférence par lots |
| Ray Train | Entraînement distribué | PyTorch, TensorFlow, fine-tuning |
| Ray Tune | Recherche d'hyperparamètres | Optimisation à grande échelle |
| Ray Serve | Serving de modèles | API d'inférence en ligne, LLM |
| RLlib | Apprentissage par renforcement | Agents et simulations |
Ray Data : préparer les données et faire de l'inférence par lots
Ray Data charge et transforme des jeux de données en flux, bloc par bloc, ce qui permet de traiter des volumes supérieurs à la mémoire d'une machine. Son intérêt principal pour l'IA est de faire cohabiter des étapes CPU (lecture, décodage, nettoyage) et des étapes GPU (inférence) dans un même pipeline, chacune avec sa propre parallélisation.
import ray

# Lecture distribuée de fichiers Parquet
ds = ray.data.read_parquet("s3://mon-bucket/avis-clients/")

def normalize(batch):
    """Mise en minuscules du texte, appliquée par lots."""
    batch["text"] = [t.lower() for t in batch["text"]]
    return batch

ds = ds.map_batches(normalize)

# Écriture du résultat, également en parallèle
ds.write_parquet("s3://mon-bucket/avis-clients-propres/")
Pour l'inférence par lots, map_batches accepte aussi une classe qui charge un modèle une seule fois par worker, avec une taille de pool et un nombre de GPU déclarés. Ce schéma évite de recharger le modèle à chaque lot et sature mieux les accélérateurs.
Ray Train : entraîner sur plusieurs GPU
Ray Train prend en charge l'orchestration de l'entraînement distribué : démarrage des workers, configuration de la communication entre eux, reprise après panne et enregistrement des points de contrôle. Le code d'entraînement reste celui du framework d'origine, avec quelques adaptations.
import ray.train.torch
from ray.train import ScalingConfig
from ray.train.torch import TorchTrainer

def train_func():
    """Boucle d'entraînement exécutée sur chaque worker."""
    model = build_model()  # votre modèle PyTorch
    model = ray.train.torch.prepare_model(model)  # DDP et placement sur le GPU

    loader = build_dataloader()
    loader = ray.train.torch.prepare_data_loader(loader)  # sharding des données

    for epoch in range(10):
        for batch in loader:
            ...  # perte, rétropropagation, optimiseur

trainer = TorchTrainer(
    train_func,
    scaling_config=ScalingConfig(num_workers=4, use_gpu=True),
)
result = trainer.fit()
Les fonctions prepare_model et prepare_data_loader adaptent le modèle et les données à l'entraînement distribué. Passer de un à huit GPU revient à modifier num_workers dans ScalingConfig. Ray Train s'intègre à PyTorch comme à TensorFlow, et les métriques comme les modèles produits peuvent être suivis avec MLflow.
Ray Tune : régler les hyperparamètres
Ray Tune lance de nombreux essais en parallèle, chacun avec une configuration différente, et peut interrompre tôt les essais peu prometteurs. Il propose des stratégies de recherche aléatoire ou en grille, et s'interface avec des bibliothèques d'optimisation bayésienne comme Optuna.
from ray import tune

def objective(config):
    """Fonction à minimiser : retourne un score pour chaque essai."""
    score = (config["lr"] - 0.01) ** 2 + config["dropout"] * 0.1
    return {"score": score}

tuner = tune.Tuner(
    objective,
    param_space={
        "lr": tune.loguniform(1e-4, 1e-1),
        "dropout": tune.uniform(0.0, 0.5),
    },
    tune_config=tune.TuneConfig(num_samples=50, metric="score", mode="min"),
)
results = tuner.fit()
print(results.get_best_result().config)
Les cinquante essais sont répartis sur les ressources du cluster. Tune peut aussi encapsuler un TorchTrainer : chaque essai devient alors lui-même un entraînement distribué.
Ray Serve : servir les modèles en production
Ray Serve expose des modèles derrière une API HTTP. Un deployment est une classe Python décorée, que Ray réplique sur le cluster, avec un nombre de répliques, des ressources et une montée en charge configurables. Serve permet de composer plusieurs modèles dans une même application, par exemple un pré-traitement, un modèle de classification et un post-traitement, chacun avec ses propres ressources.
from ray import serve
from starlette.requests import Request

@serve.deployment(num_replicas=2, ray_actor_options={"num_cpus": 1})
class Classifier:
    def __init__(self):
        self.model = load_model()  # chargé une fois par réplique

    async def __call__(self, request: Request):
        payload = await request.json()
        return {"label": self.model.predict(payload["features"])}

app = Classifier.bind()
serve.run(app, route_prefix="/predict")
Serve propose également une intégration pour les LLM, qui s'appuie sur des moteurs comme vLLM pour le batching continu. Pour un service plus orienté Kubernetes natif, KServe constitue une alternative à comparer.
À découvrir : notre formation MLOps
Déployer Ray sur Kubernetes avec KubeRay
En production, Ray tourne le plus souvent sur Kubernetes. KubeRay est l'opérateur recommandé : il exécute chaque nœud Ray dans un Pod, avec un Pod head et des Pods workers, et expose des ressources personnalisées (CRD) pour décrire les clusters.
- RayCluster : décrit un cluster Ray persistant, avec son head et ses groupes de workers.
- RayJob : lance un cluster pour exécuter un programme précis, puis peut le supprimer une fois le travail terminé.
- RayService : déploie une application Ray Serve avec mise à jour progressive et reprise en cas de panne du cluster.
L'installation de l'opérateur passe généralement par un chart Helm. On décrit ensuite le cluster dans un manifeste YAML :
apiVersion: ray.io/v1
kind: RayCluster
metadata:
  name: ray-ml
spec:
  # Mise à l'échelle automatique des workers selon la charge
  enableInTreeAutoscaling: true
  headGroupSpec:
    rayStartParams: {}
    template:
      spec:
        containers:
          - name: ray-head
            image: rayproject/ray:latest
            resources:
              limits:
                cpu: "2"
                memory: 8Gi
  workerGroupSpecs:
    - groupName: gpu-workers
      replicas: 1
      minReplicas: 0
      maxReplicas: 8
      rayStartParams: {}
      template:
        spec:
          containers:
            - name: ray-worker
              image: rayproject/ray:latest
              resources:
                limits:
                  cpu: "8"
                  memory: 32Gi
                  nvidia.com/gpu: 1
Dans un environnement réel, on épingle une version précise de l'image plutôt que latest, et on utilise la même version de Ray pour le head et les workers. L'autoscaler ajoute ou retire des Pods workers entre minReplicas et maxReplicas selon les ressources demandées par les tasks et les actors. Combiné à un autoscaler de nœuds Kubernetes, il permet de ne payer les GPU que pendant les phases de calcul. KubeRay prend aussi en charge des groupes de workers hétérogènes, ce qui convient aux pipelines qui mélangent CPU et GPU.
Ray face à Spark : choisir la bonne approche
Ray et Apache Spark sont deux moteurs de calcul distribué, mais ils ne répondent pas aux mêmes besoins. Spark est né pour le traitement de données tabulaires à grande échelle, avec un modèle déclaratif (DataFrames, SQL). Ray a été conçu pour des charges hétérogènes et dynamiques, typiques de l'IA.
| Critère | Ray | Spark |
|---|---|---|
| Modèle de programmation | Tasks et actors Python, graphe dynamique | DataFrames et SQL, plan optimisé |
| Point fort | Entraînement, inférence, simulation | ETL, analyse de données massives |
| Gestion des GPU | Native, ressource de premier ordre | Possible, mais moins centrale |
| État en mémoire | Actors avec état | Plutôt sans état |
| Maturité des outils SQL | Limitée | Très riche |
Les deux outils sont complémentaires plus que concurrents. Un schéma fréquent consiste à préparer et agréger les données avec Spark, puis à confier l'entraînement et l'inférence à Ray, qui lit les mêmes fichiers Parquet. Pour un projet qui se résume à de la transformation de données tabulaires, Spark reste généralement le choix le plus simple et le mieux outillé. Dès que l'on manipule des modèles, des GPU, des images ou du texte, ou que l'on veut un état partagé entre processus, Ray devient plus naturel.
Ray n'est pas non plus nécessaire pour tous les projets. Pour un modèle qui s'entraîne sur une seule machine, la complexité d'un cluster n'apporte rien. Il devient rentable lorsque le volume de données, la taille du modèle ou le nombre d'essais dépassent les capacités d'un seul nœud, ou lorsque l'on souhaite unifier, sur une même plateforme, les étapes de prétraitement, d'entraînement et de serving que l'on gère aujourd'hui avec des outils séparés.
Conclusion
Ray apporte une réponse cohérente au passage à l'échelle des projets d'IA. Avec trois primitives (tasks, actors et object store), il rend le calcul distribué accessible à toute personne qui écrit du Python. Ses bibliothèques Data, Train, Tune et Serve reprennent ensuite ces concepts pour couvrir le prétraitement, l'entraînement, le réglage des hyperparamètres et le serving, sur un même cluster et avec une même gestion des ressources.
KubeRay inscrit Ray dans les pratiques de déploiement actuelles : un cluster décrit en YAML, une mise à l'échelle automatique, des GPU facturés à l'usage. Face à Spark, il ne s'agit pas de choisir un camp, mais de confier à chaque moteur les charges pour lesquelles il est le plus à l'aise. Il est prudent de consulter la documentation officielle avant de fixer une version, car les API des bibliothèques évoluent d'une version à l'autre.
Savoir distribuer l'entraînement et l'inférence d'un modèle est devenu une compétence différenciante pour les Machine Learning Engineers, à mesure que les modèles grossissent et que les équipes doivent maîtriser leurs coûts de calcul. Ray est l'une des briques qui permettent de passer d'un notebook à une plateforme de production capable de suivre cette montée en charge.