GraphRAG : enrichir le RAG avec les graphes de connaissances
Un RAG vectoriel répond très bien aux questions dont la réponse tient dans un ou deux passages d'un document. Mais que se passe-t-il lorsqu'on demande « quels sont les grands thèmes de ce corpus ? » ou « quel lien relie ce fournisseur à cet incident ? » Dans ces cas, la recherche par similarité ramène des fragments isolés et le modèle ne peut pas reconstituer la vue d'ensemble. C'est le problème que cherche à résoudre GraphRAG.
Équipe Blent
Publié le · 11 min de lecture
Dans cet article
Un RAG vectoriel répond très bien aux questions dont la réponse tient dans un ou deux passages d'un document. Mais que se passe-t-il lorsqu'on demande « quels sont les grands thèmes de ce corpus ? » ou « quel lien relie ce fournisseur à cet incident ? » Dans ces cas, la recherche par similarité ramène des fragments isolés et le modèle ne peut pas reconstituer la vue d'ensemble. C'est le problème que cherche à résoudre GraphRAG.
Introduit par Microsoft Research, GraphRAG ajoute au RAG une étape de structuration : un LLM extrait les entités et leurs relations pour construire un graphe de connaissances, puis ce graphe est découpé en communautés thématiques que le modèle résume. Au moment de la question, la réponse s'appuie sur ces structures plutôt que sur de simples chunks. Le principe a inspiré plusieurs projets open source (LightRAG, Neo4j GraphRAG) et il est aujourd'hui l'une des évolutions les plus discutées des architectures de retrieval.
Dans cet article, nous allons voir pourquoi le RAG classique atteint ses limites, détailler le pipeline d'indexation de GraphRAG et ses modes de recherche, comparer les principales implémentations, puis évaluer le compromis entre coût d'indexation et qualité des réponses.
Pourquoi le RAG vectoriel atteint ses limites
Le RAG classique découpe les documents en chunks, les transforme en vecteurs et retrouve les passages les plus proches de la question. Cette approche suppose implicitement que la réponse se trouve localement dans quelques passages. C'est vrai pour une question factuelle (« quelle est la durée de préavis dans ce contrat ? »), beaucoup moins pour deux familles de questions :
- Les questions globales : « quelles sont les principales tendances dans ces 2 000 comptes rendus ? ». Aucun chunk ne contient la réponse, qui exige de synthétiser l'ensemble du corpus. C'est une tâche de résumé orienté requête, pas de recherche.
- Les questions multi-sauts : « quels projets dépendent d'une bibliothèque maintenue par l'équipe dirigée par Marie ? ». La réponse suppose de traverser plusieurs relations (personne, équipe, bibliothèque, projet) réparties dans des documents différents, que la similarité sémantique ne rapproche pas.
Les techniques d'amélioration habituelles, comme le reranking ou la fusion de classements, optimisent le choix des passages mais ne changent pas la nature du problème : on reste limité par les chunks récupérés. Il faut donc une représentation qui capture explicitement les entités et leurs liens, c'est exactement ce qu'offre un graphe de connaissances.
| Type de question | RAG vectoriel | GraphRAG |
|---|---|---|
| Fait précis dans un passage | Très bon | Bon, mais surdimensionné |
| Relation entre entités éloignées | Faible | Bon (multi-sauts) |
| Thèmes généraux du corpus | Très faible | Très bon (recherche globale) |
| Coût d'indexation | Faible | Élevé (appels LLM) |
Le pipeline d'indexation de GraphRAG
La force de GraphRAG vient d'un travail réalisé en amont, à l'indexation. Le pipeline de Microsoft se décompose en grandes étapes, chacune produisant des tables (au format Parquet) réutilisées au moment de la requête.
Découpage et extraction d'entités
Les documents sont d'abord découpés en TextUnits, des fragments de texte qui servent d'unité d'analyse et permettent de remonter à la source de chaque information. Par défaut, leur taille est de l'ordre de 1 200 tokens.
Un LLM parcourt ensuite chaque TextUnit pour extraire les entités (personnes, organisations, lieux, concepts), les relations qui les unissent et leur description. Les descriptions d'une même entité rencontrée à plusieurs endroits sont fusionnées et résumées. L'extraction d'affirmations (claims) est également possible, mais elle est désactivée par défaut. Cette étape concentre l'essentiel des appels au modèle, donc l'essentiel de la facture.
Détection de communautés
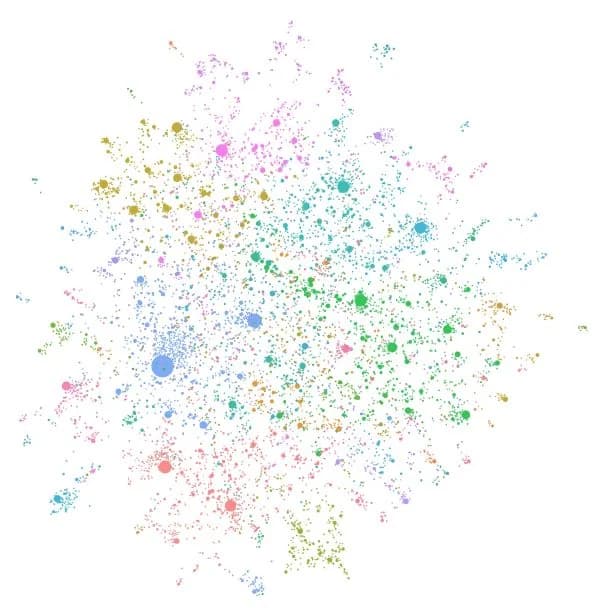
Le graphe obtenu est partitionné par l'algorithme de Leiden, appliqué de façon hiérarchique. Une communauté est un groupe d'entités densément reliées entre elles, par exemple tous les acteurs d'un même projet ou d'une même thématique. La hiérarchie permet de disposer de plusieurs niveaux de granularité : des communautés larges au sommet, des groupes très ciblés en bas.
Résumés de communautés
Pour chaque communauté, le LLM rédige un rapport qui décrit ses entités principales, leurs relations et les points saillants. Ces rapports sont produits de bas en haut : les communautés de haut niveau s'appuient sur les résumés de leurs sous-communautés. Enfin, les descriptions d'entités, les TextUnits et les rapports sont vectorisés (embeddings) et stockés dans une base vectorielle.
À découvrir : notre formation LLM Engineering
Recherche locale et recherche globale
GraphRAG propose plusieurs modes de requête, adaptés à des types de questions différents.
- Recherche locale (local search) : pour les questions centrées sur une entité précise. Le système identifie les entités proches de la question par similarité, puis parcourt leurs voisins dans le graphe, leurs relations et les TextUnits associés pour construire le contexte.
- Recherche globale (global search) : pour les questions portant sur l'ensemble du corpus. Le système interroge les rapports de communautés, en deux temps de type map-reduce : chaque lot de rapports produit une réponse partielle, puis ces réponses sont agrégées en une synthèse finale.
- DRIFT search : un mode hybride qui part du contexte des communautés pour enrichir une recherche locale, utile quand la question est à la fois large et précise.
- Basic search : une recherche vectorielle classique, équivalente à un RAG standard, qui sert de point de comparaison.
Le choix du mode revient à l'application. Une question comme « que sait-on de la société X ? » relève de la recherche locale, tandis que « quels sont les risques récurrents évoqués dans l'ensemble des audits ? » nécessite la recherche globale. Dans un système plus évolué, un routeur peut choisir lui-même la stratégie, ce qui rejoint les principes de l'Agentic RAG.
Avec le paquet officiel, la mise en œuvre tient en quelques commandes :
pip install graphrag

# Initialiser le projet (génère settings.yaml, les prompts et le dossier input)
graphrag init --root ./ragtest

# Placer les documents texte dans ./ragtest/input, puis lancer l'indexation
graphrag index --root ./ragtest

# Question globale, résolue à partir des résumés de communautés
graphrag query --root ./ragtest --method global --query "Quels sont les grands thèmes du corpus ?"

# Question locale, centrée sur une entité
graphrag query --root ./ragtest --method local --query "Quel rôle joue Marie Dupont dans le projet Orion ?"
La commande init crée un fichier settings.yaml dans lequel on configure le modèle de chat, le modèle d'embedding et la taille des chunks. L'indexation peut durer longtemps et coûter cher sur un gros corpus : il est conseillé de la tester d'abord sur un échantillon de documents. La documentation recommande aussi le réglage des prompts (prompt tuning) pour adapter l'extraction d'entités à votre domaine, une étape qui améliore nettement la qualité du graphe.
Les principales implémentations
L'écosystème ne se limite pas à la bibliothèque de Microsoft. Trois approches coexistent, avec des philosophies différentes.
Microsoft GraphRAG
C'est l'implémentation de référence, celle qui propose les résumés de communautés et la recherche globale. Elle fonctionne en mode batch : on indexe un corpus, puis on l'interroge. Elle convient aux corpus relativement stables (rapports, veille, documentation, enquêtes) et aux équipes qui veulent des réponses de synthèse. Le revers est le coût et la rigidité : une mise à jour importante peut imposer de refaire une partie de l'indexation.
LightRAG
LightRAG se présente comme une alternative plus légère. Il combine un graphe de connaissances et des embeddings, mais n'utilise pas les rapports de communautés : la récupération passe par les entités (mode local) et par les relations (mode global), avec des modes hybrid et mix (le mode par défaut, qui ajoute la recherche vectorielle classique). Son atout principal est la mise à jour incrémentale : on peut ajouter ou supprimer des documents sans tout reconstruire. Voici un exemple d'utilisation :
import asyncio
from lightrag import LightRAG, QueryParam
from lightrag.llm.openai import gpt_4o_mini_complete, openai_embed


async def main():
    # Le dossier de travail contient le graphe et les index vectoriels
    rag = LightRAG(
        working_dir="./lightrag_data",
        llm_model_func=gpt_4o_mini_complete,
        embedding_func=openai_embed,
    )
    # Étape obligatoire : sans elle, les requêtes échouent
    await rag.initialize_storages()

    # Insertion d'un document : extraction des entités et relations par le LLM
    with open("rapport_audit.txt", encoding="utf-8") as f:
        await rag.ainsert(f.read())

    # Interrogation en mode mix (graphe + vecteurs)
    reponse = await rag.aquery(
        "Quels risques reviennent dans les audits ?",
        param=QueryParam(mode="mix"),
    )
    print(reponse)


asyncio.run(main())
Les signatures évoluent d'une version à l'autre : il faut se référer à la documentation du dépôt pour la version installée. Les performances annoncées par les auteurs de LightRAG face à GraphRAG proviennent de leurs propres évaluations, à vérifier sur vos données.
Neo4j et le paquet neo4j-graphrag
Pour les équipes qui disposent déjà d'une base de graphes, Neo4j propose le paquet Python neo4j-graphrag. Il fournit un pipeline de construction du graphe (SimpleKGPipeline, qui prend en entrée du texte ou des PDF, un LLM pour l'extraction et un modèle d'embedding), plusieurs retrievers (vectoriel, vectoriel enrichi par une requête Cypher, Text2Cypher) et une classe GraphRAG qui associe un retriever à un LLM. L'approche est différente : on exploite le graphe comme une base de données que l'on interroge en Cypher, ce qui donne un contrôle fin sur le schéma et sur la traversée, au prix d'un travail de modélisation plus important.
| Critère | Microsoft GraphRAG | LightRAG | Neo4j GraphRAG |
|---|---|---|---|
| Résumés de communautés | Oui | Non | Non (à construire) |
| Mises à jour incrémentales | Limitées | Oui | Oui (base de graphes) |
| Question globale | Très bonne | Correcte | Dépend du design |
| Contrôle du schéma | Faible | Faible | Fort (Cypher) |
| Stockage | Fichiers Parquet | Fichiers ou PostgreSQL | Neo4j |
Coût d'indexation contre qualité des réponses
Le compromis est la question centrale avant d'adopter GraphRAG. Un RAG vectoriel n'appelle un modèle d'embedding qu'une fois par chunk, ce qui est très peu coûteux. GraphRAG, lui, fait appel à un LLM génératif pour chaque TextUnit (extraction), puis pour chaque entité fusionnée et chaque communauté (résumés). Sur un corpus volumineux, le nombre de tokens traités est un multiple de la taille des documents, et la facture suit. Les stratégies de FinOps pour les LLM s'appliquent donc dès la phase d'indexation.
Plusieurs leviers permettent de maîtriser ce coût :
- Utiliser un modèle plus petit pour l'extraction : l'extraction d'entités est une tâche structurée qu'un modèle économique réalise souvent correctement, surtout après un réglage des prompts.
- Indexer un échantillon d'abord : valider le schéma d'entités et la qualité des résumés sur quelques dizaines de documents avant de lancer le corpus complet.
- Limiter le périmètre : ne pas passer dans le graphe les documents purement factuels, qu'un RAG vectoriel traite très bien.
- Choisir une approche incrémentale : si le corpus évolue souvent, LightRAG ou une base de graphes évite de repayer l'indexation complète.
Côté qualité, les publications de Microsoft montrent que la recherche globale produit des réponses jugées plus complètes et plus variées que celles d'un RAG vectoriel sur les questions de synthèse. En revanche, sur les questions factuelles simples, le gain est faible, voire nul. La bonne démarche consiste à mesurer sur vos propres questions : construire un jeu d'évaluation qui mélange questions locales, globales et multi-sauts, puis comparer les systèmes avec des outils comme RAGAS et les méthodes décrites dans notre guide pour évaluer un RAG. Une qualité de graphe médiocre (entités dupliquées, relations erronées) dégrade les réponses autant qu'elle les améliore lorsqu'elle est bonne.
Un dernier point de vigilance concerne la fraîcheur et la traçabilité : les résumés de communautés sont figés au moment de l'indexation, et une réponse de synthèse est plus difficile à vérifier qu'un extrait cité. Conserver les liens vers les TextUnits sources, comme le fait GraphRAG, permet de justifier chaque affirmation.
À découvrir : notre formation LLM Engineering
Conclusion
GraphRAG répond à une limite précise du RAG vectoriel : l'incapacité à traiter les questions qui exigent une vue d'ensemble ou la traversée de plusieurs relations. En construisant un graphe de connaissances, en le découpant en communautés et en résumant celles-ci, il transforme un corpus en une structure interrogeable à plusieurs échelles, de l'entité isolée jusqu'aux grands thèmes.
Ce gain a un prix : un pipeline d'indexation lourd, des appels LLM nombreux et un travail de réglage pour que le graphe reflète bien votre domaine. Microsoft GraphRAG est l'option de référence pour la synthèse globale, LightRAG privilégie la légèreté et les mises à jour incrémentales, et Neo4j s'impose quand le graphe est déjà au cœur du système d'information.
Pour un développeur qui dispose déjà d'un RAG en production, la démarche la plus sûre est progressive : identifier les questions qu'il traite mal, tester une implémentation graphe sur un échantillon, et ne généraliser que si la mesure confirme l'apport. Savoir choisir entre recherche vectorielle, graphe et approche hybride devient une compétence différenciante pour concevoir des applications d'IA générative à la fois précises et économiques.