TabPFN : le modèle de fondation pour données tabulaires
Les modèles de fondation ont transformé le texte, l'image, puis les séries temporelles, mais les données tabulaires, celles des tableaux et des bases de données qui font le quotidien des entreprises, résistaient encore : sur ce terrain, le gradient boosting avec XGBoost ou LightGBM restait la référence, au prix d'un entraînement et d'un réglage pour chaque nouveau jeu de données. TabPFN, développé par Prior Labs et publié dans Nature en 2025, change la donne : ce modèle pré-entraîné prédit directement sur vos données, sans entraînement spécifique, en une seule passe avant.
Équipe Blent
Publié le · 12 min de lecture
Dans cet article
Les modèles de fondation ont transformé le texte, l'image, puis les séries temporelles, mais les données tabulaires, celles des tableaux et des bases de données qui font le quotidien des entreprises, résistaient encore : sur ce terrain, le gradient boosting avec XGBoost ou LightGBM restait la référence, au prix d'un entraînement et d'un réglage pour chaque nouveau jeu de données. TabPFN, développé par Prior Labs et publié dans Nature en 2025, change la donne : ce modèle pré-entraîné prédit directement sur vos données, sans entraînement spécifique, en une seule passe avant.
Le principe rappelle celui des LLM et de leur apprentissage en contexte : on fournit au modèle des exemples, et il produit la réponse. Ici, les exemples sont les lignes de votre jeu d'entraînement avec leurs étiquettes, et la réponse est la prédiction pour les nouvelles lignes. Le modèle a été pré-entraîné sur des millions de jeux de données entièrement synthétiques, ce qui lui évite tout contact avec vos données lors de la phase d'apprentissage. Après les modèles de fondation pour séries temporelles, c'est la même logique appliquée aux tableaux.
TabPFN remplace-t-il vraiment XGBoost ? Jusqu'à quelle taille de jeu de données fonctionne-t-il ? Peut-on l'utiliser en production ? Dans cet article, nous allons expliquer le principe des Prior-Data Fitted Networks, détailler les limites de taille et de licence selon les versions, dérouler un exemple compatible scikit-learn, puis comparer honnêtement TabPFN aux approches par gradient boosting.
Qu'est-ce que TabPFN ?
TabPFN signifie Tabular Prior-Data Fitted Network. La première version, présentée en 2022 puis à la conférence ICLR 2023, était limitée à de petits jeux de données de classification. La version 2, publiée dans la revue Nature en 2025 par une équipe menée par Noah Hollmann, Samuel Müller, Lennart Purucker et Frank Hutter, a étendu le modèle à la régression, aux valeurs manquantes et aux variables catégorielles. Prior Labs, la société créée en 2024 pour le développer, a ensuite publié les versions 2.5 (novembre 2025), 3 (mai 2026) puis 3.5 (septembre 2026), chacune repoussant les limites de taille.
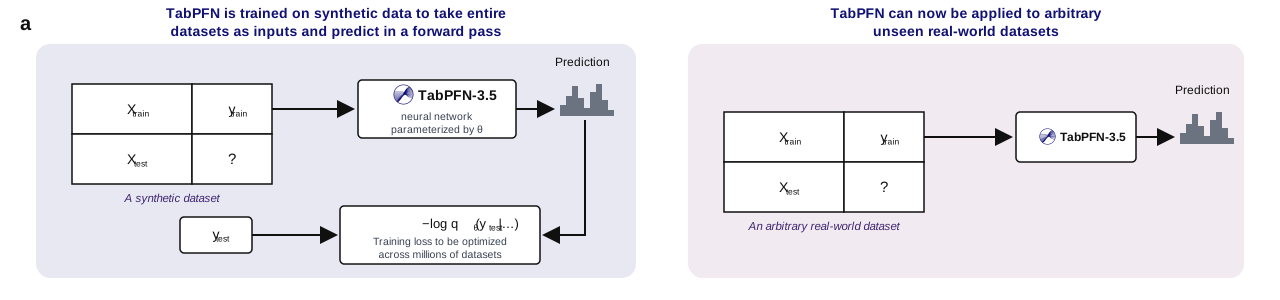
L'idée centrale tient en une phrase : au lieu d'entraîner un modèle sur chaque jeu de données, on entraîne une seule fois un réseau à résoudre des problèmes de prédiction tabulaire en général. Une fois ce pré-entraînement terminé, la méthode fit ne réalise plus d'optimisation par descente de gradient, elle se contente de mémoriser le jeu d'entraînement comme contexte. L'appel à predict fait alors passer ce contexte et les nouvelles lignes dans le réseau, qui renvoie directement les prédictions.
Ce fonctionnement apporte trois bénéfices pour un Data Scientist :
- Aucun entraînement dédié : pas de boucle d'optimisation, pas de nombre d'arbres ni de profondeur à choisir.
- Peu de préparation : les valeurs manquantes, les variables catégorielles et les échelles différentes sont gérées par le modèle.
- Bons résultats sur petits jeux de données : là où le surapprentissage guette, le modèle s'appuie sur ce qu'il a appris sur des millions de problèmes similaires.
Comment fonctionnent les Prior-Data Fitted Networks ?
Un PFN est un réseau de neurones entraîné à approximer l'inférence bayésienne. Pour comprendre le mécanisme, il faut distinguer la phase de pré-entraînement, réalisée par Prior Labs, de la phase d'utilisation, réalisée par vous.
Un pré-entraînement sur données synthétiques
Plutôt que de collecter des jeux de données réels, les auteurs génèrent des tableaux artificiels à partir d'un a priori (le prior), c'est-à-dire une famille de mécanismes plausibles pour produire des données. Cet a priori repose sur des modèles causaux et des réseaux de neurones bayésiens, avec des relations non linéaires, des interactions entre variables, du bruit, des valeurs manquantes, des classes déséquilibrées et des variables inutiles. La version 2 a été pré-entraînée sur environ 130 millions de jeux de données de ce type.
Chaque jeu synthétique est découpé en lignes d'entraînement, dont les étiquettes sont visibles, et en lignes de test, dont les étiquettes sont masquées. Le réseau doit prédire les étiquettes masquées en une seule passe, et la perte (une log-vraisemblance négative) l'oriente vers la bonne prédiction. Ce choix de données synthétiques évite aussi la contamination des benchmarks, puisque le modèle n'a jamais vu de jeu de données réel.
Un Transformer qui lit lignes et colonnes
Le réseau repose sur l'architecture Transformer, adaptée à la structure d'un tableau. Contrairement à une phrase, un tableau n'a pas d'ordre : permuter les lignes ou les colonnes ne doit pas changer la prédiction. TabPFN alterne donc des couches d'attention entre les colonnes d'une même ligne, qui capturent les interactions entre variables, et des couches d'attention entre les lignes d'une même colonne, qui permettent à chaque ligne de test de se comparer aux exemples d'entraînement.
À l'inférence, le jeu d'entraînement joue le rôle du contexte. C'est de l'apprentissage en contexte (in-context learning), comme pour un LLM auquel on fournit des exemples dans le prompt, à ceci près que le mécanisme a été appris sur des tableaux plutôt que sur du texte. La version 3.5 combine un modèle unique pour la classification et la régression, avec environ 220 millions de paramètres.
Les limites de taille et de licence
TabPFN n'est pas un remplaçant universel de XGBoost, et ses contraintes se jouent sur deux plans : la taille des données et les conditions d'usage.
La taille des jeux de données
Comme le jeu d'entraînement complet est lu à chaque prédiction, le coût de calcul et de mémoire croît avec le nombre de lignes et de colonnes. Chaque génération de modèle a repoussé ces bornes :
| Version | Publication | Lignes d'entraînement | Colonnes |
|---|---|---|---|
| TabPFN v2 | 2025 (Nature) | 10 000 | 500 |
| TabPFN-2.5 | Novembre 2025 | 100 000 | 2 000 |
| TabPFN-3 | Mai 2026 | 1 000 000 | 2 000 |
| TabPFN-3.5 | Septembre 2026 | 1 000 000 | 20 000 (6 000 recommandées) |
Ces chiffres sont les bornes annoncées par Prior Labs, et elles ne se cumulent pas toujours : les performances sont validées par les auteurs pour des combinaisons précises (par exemple 100 000 lignes avec 2 000 colonnes, ou 1 000 lignes avec 20 000 colonnes), pas pour tous les croisements possibles. Il faut donc tester sur son propre volume. Au-delà des limites, le paramètre ignore_pretraining_limits=True lève la protection, mais sans garantie de qualité, et un sous-échantillonnage par estimateur est possible avec l'option SUBSAMPLE_SAMPLES.
Le matériel compte autant que le volume. Un GPU est recommandé, y compris un modèle ancien avec environ 8 Go de mémoire vidéo pour les jeux moyens. Sur CPU, la bibliothèque limite par défaut les versions récentes à 5 000 lignes, ce qui suffit pour expérimenter mais pas pour un gros volume. Les grands jeux de données exigent donc une infrastructure GPU, ou le service hébergé de Prior Labs via le paquet tabpfn-client.
Une licence à vérifier
Le code de la bibliothèque est sous licence Apache 2.0 depuis la version 9.0.0 du paquet. Les poids des modèles suivent en revanche leurs propres licences : ceux de TabPFN-2 sont sous une licence Apache 2.0 avec une exigence de mention, tandis que ceux des versions 2.5, 2.6, 3 et 3.5 sont sous licences non commerciales. La recherche, l'évaluation et les benchmarks internes sont permis, mais un usage en production ou la mise à disposition en service hébergé nécessitent une licence commerciale auprès de Prior Labs. Cette contrainte pèse sur le choix de version et mérite d'être validée avec les équipes juridiques avant tout déploiement.
Exemple : utiliser TabPFN avec scikit-learn
TabPFN expose des classes TabPFNClassifier et TabPFNRegressor qui respectent l'API de scikit-learn, avec fit, predict et predict_proba. Elles s'intègrent donc dans un pipeline scikit-learn, une recherche d'hyperparamètres ou une validation croisée. L'installation passe par pip, et le poids du modèle est téléchargé au premier appel.
pip install tabpfn xgboost scikit-learn
Nous comparons ici TabPFN et XGBoost sur un jeu de classification synthétique de 3 000 lignes, volume compatible avec une exécution sur CPU, en utilisant la même validation croisée pour les deux modèles.
from sklearn.datasets import make_classification
from sklearn.model_selection import cross_val_score
from tabpfn import TabPFNClassifier
from xgboost import XGBClassifier

# Jeu de données synthétique : 3 000 lignes, 20 variables, 10 informatives
X, y = make_classification(
    n_samples=3000, n_features=20, n_informative=10, random_state=42
)

# TabPFN : aucun hyperparamètre à régler, fit mémorise simplement le contexte
tabpfn = TabPFNClassifier()

# XGBoost : réglages par défaut raisonnables pour la comparaison
xgboost = XGBClassifier(n_estimators=300, learning_rate=0.05, max_depth=4)

# Même validation croisée à 5 plis pour les deux modèles
for nom, modele in [("TabPFN", tabpfn), ("XGBoost", xgboost)]:
    scores = cross_val_score(modele, X, y, cv=5, scoring="roc_auc")
    print(f"{nom} : AUC moyenne = {scores.mean():.3f} (+/- {scores.std():.3f})")
Le code ne précise aucun nombre d'arbres, de profondeur ou de taux d'apprentissage pour TabPFN. Pour choisir une autre version que celle par défaut, on passe par TabPFNClassifier.create_default_for_version(ModelVersion.V3), avec ModelVersion importé depuis tabpfn.constants. Sur GPU, le paramètre device="auto" sélectionne automatiquement la carte graphique disponible.
Le résultat dépend du jeu de données : sur des données synthétiques, l'écart entre les deux modèles n'a aucune valeur de benchmark. Cet exemple sert surtout de squelette pour comparer TabPFN à votre modèle actuel sur vos propres données, avec la même découpe et la même métrique, en gardant en tête le temps de prédiction qui sera plus élevé pour TabPFN que pour un modèle d'arbres déjà entraîné.
TabPFN face à XGBoost et LightGBM
La comparaison honnête commence par une réserve : les résultats publiés par Prior Labs sont ceux de l'éditeur, obtenus sur des benchmarks choisis par ses auteurs. L'article de Nature rapporte que TabPFN v2 surpasse des modèles à base d'arbres réglés sur des jeux de données allant jusqu'à 10 000 lignes, en une fraction du temps de réglage. Au-delà de ce périmètre, les résultats dépendent fortement des versions et des jeux de données, et mieux vaut les vérifier soi-même.
| Critère | TabPFN | XGBoost | LightGBM |
|---|---|---|---|
| Entraînement | Aucun (apprentissage en contexte) | Oui, par jeu de données | Oui, par jeu de données |
| Réglage d'hyperparamètres | Minimal | Important pour de bons résultats | Important pour de bons résultats |
| Petits jeux de données | Très performant | Bon, avec réglage | Bon, avec réglage |
| Très gros volumes | Limité, GPU nécessaire | Excellent | Excellent, très rapide |
| Coût d'inférence | Élevé (relit le contexte) | Très faible | Très faible |
| Explicabilité | Faible, outils post hoc | Importance des variables, SHAP | Importance des variables, SHAP |
| Licence des poids | Non commerciale (versions récentes) | Apache 2.0 | MIT |
Ce tableau montre que les deux approches ne se placent pas sur le même terrain. Les modèles d'arbres, détaillés dans nos articles sur XGBoost et LightGBM, restent imbattables en coût d'inférence : une fois entraîné, un modèle de quelques mégaoctets prédit des millions de lignes sur un simple CPU. Ils s'exportent facilement, se surveillent avec des outils éprouvés et acceptent une licence permissive. Leur interprétabilité est aussi mieux outillée.
TabPFN s'impose dans d'autres situations :
- Peu de données : quelques centaines à quelques milliers de lignes, typiquement en santé, en industrie ou en finance, où chaque exemple coûte cher.
- Baseline rapide : un premier score sans passer par la recherche d'hyperparamètres, utile pour décider si un projet vaut l'investissement.
- Prototypage : comparer vite plusieurs jeux de variables lors du feature engineering, sans relancer un réglage à chaque essai.
- Combinaison avec des arbres : certaines équipes utilisent les prédictions ou les représentations de TabPFN comme variables supplémentaires pour un gradient boosting.
La démarche la plus sûre reste celle d'un backtest comparatif : on évalue TabPFN et un modèle d'arbres réglé avec la même validation croisée, puis on pèse le gain de performance contre le coût d'inférence, la licence et la maturité de l'outillage MLOps. Si l'écart est faible, le modèle le plus simple à exploiter l'emporte.
À découvrir : notre formation Data Scientist
Conclusion
TabPFN montre que le principe des modèles de fondation s'applique aux données tabulaires. En déplaçant l'apprentissage vers un pré-entraînement unique sur des données synthétiques, il remplace la phase d'entraînement et de réglage par une simple lecture du contexte, et donne de très bons résultats sur les petits et moyens jeux de données. Les versions successives, jusqu'à TabPFN-3.5, ont repoussé les limites jusqu'à un million de lignes et plusieurs milliers de colonnes.
Cela ne rend pas XGBoost et LightGBM obsolètes. Le gradient boosting garde l'avantage sur le coût d'inférence, la sobriété matérielle, l'explicabilité et la liberté de licence, et reste la solution la plus naturelle pour les gros volumes en production. TabPFN complète cette boîte à outils plutôt qu'il ne la remplace : baseline immédiate, outil de choix sur peu de données, brique à combiner avec des arbres.
Le domaine bouge vite, avec une nouvelle version majeure tous les quelques mois. Savoir évaluer ces modèles sur vos propres données, mesurer leur coût réel et trancher entre un modèle pré-entraîné et une méthode classique devient une compétence différenciante pour un Data Scientist.