Conformal Prediction : quantifier l'incertitude des modèles
Un modèle qui prédit 312 000 euros pour un appartement ou affirme qu'une transaction est légitime à 87 % ne dit pas à quel point il peut se tromper, alors que cette information conditionne la décision qui suit. Les probabilités de sortie des classifieurs sont souvent mal calibrées, et la plupart des modèles de régression ne renvoient qu'une valeur unique. La prédiction conforme (conformal prediction) répond à ce besoin : cette méthode transforme n'importe quel modèle en un outil qui fournit des intervalles ou des ensembles de prédiction assortis d'une garantie de couverture.
Équipe Blent
Publié le · 12 min de lecture
Dans cet article
Un modèle qui prédit 312 000 euros pour un appartement ou affirme qu'une transaction est légitime à 87 % ne dit pas à quel point il peut se tromper, alors que cette information conditionne la décision qui suit. Les probabilités de sortie des classifieurs sont souvent mal calibrées, et la plupart des modèles de régression ne renvoient qu'une valeur unique. La prédiction conforme (conformal prediction) répond à ce besoin : cette méthode transforme n'importe quel modèle en un outil qui fournit des intervalles ou des ensembles de prédiction assortis d'une garantie de couverture.
Ses principes ont été posés dans les années 2000 par Vladimir Vovk et ses collègues, mais la méthode connaît un regain d'intérêt avec l'essor du Machine Learning en production. Elle séduit pour trois raisons : elle ne dépend pas du modèle (une forêt aléatoire, un réseau de neurones ou un modèle de gradient boosting conviennent), elle ne suppose aucune distribution particulière des données, et elle s'appuie sur un simple jeu de calibration. Elle est portée dans l'écosystème Python par la bibliothèque MAPIE, compatible scikit-learn.
Que signifie réellement une garantie de couverture ? Comment la calcule-t-on à partir d'un jeu de calibration ? En quoi la classification diffère-t-elle de la régression ? Dans cet article, nous allons expliquer l'intuition de la méthode, détailler les scores de non-conformité, comparer les cas de la régression et de la classification, puis mettre en pratique la prédiction conforme avec MAPIE.
Pourquoi quantifier l'incertitude ?
Un modèle de Machine Learning est entraîné pour minimiser une erreur moyenne, pas pour indiquer sa confiance sur chaque prédiction. Pourtant, dans de nombreux contextes, la décision dépend de cette confiance : un médecin ne traite pas de la même façon un diagnostic certain et un diagnostic incertain, un assureur ne fixe pas un tarif sur une estimation dont la marge d'erreur est de 50 %.
Les limites des approches usuelles
Plusieurs techniques existent pour exprimer l'incertitude, mais chacune a ses faiblesses :
- Probabilités de sortie : le
predict_probad'un classifieur n'est pas une probabilité calibrée. Un arbre ou une forêt aléatoire peut afficher 0,9 pour une classe qui n'est correcte que dans 70 % des cas, et les réseaux de neurones modernes sont connus pour leur excès de confiance. - Intervalles paramétriques : ceux d'une régression linéaire reposent sur l'hypothèse de résidus gaussiens et de variance constante, rarement vérifiée en pratique.
- Méthodes bayésiennes et ensembles : elles fournissent une mesure d'incertitude riche, mais coûteuse à calculer et sans garantie formelle sur la couverture réelle.
- Erreur moyenne en validation : une validation croisée donne une erreur globale, pas une marge d'erreur pour une prédiction individuelle.
Ce qu'apporte la garantie de couverture
La prédiction conforme renvoie, pour chaque nouvelle observation, non plus une valeur mais une région de prédiction : un intervalle en régression, un ensemble de classes candidates en classification. Pour un niveau de confiance de 90 %, la méthode garantit que la vraie valeur appartiendra à cette région dans au moins 90 % des cas, en moyenne sur les nouvelles données.
Cette garantie est valable pour un échantillon fini, sans hypothèse sur la loi des données, avec une seule condition : les données de calibration et les données futures doivent être échangeables, ce qui est le cas lorsqu'elles sont tirées de façon indépendante de la même distribution. Elle ne dit en revanche rien d'un changement de distribution, que nous aborderons plus loin.
Comprendre la prédiction conforme
L'idée de départ est simple : mesurer à quel point le modèle se trompe sur des données qu'il n'a pas vues, puis utiliser cette erreur observée pour calibrer la taille des régions de prédiction futures.
Le principe de la calibration
La procédure la plus répandue, appelée split conformal prediction, découpe les données en trois parties :
- Jeu d'entraînement : il sert à ajuster le modèle, comme d'habitude.
- Jeu de calibration (ou de conformalisation) : il n'a jamais servi à l'entraînement et permet de mesurer les erreurs du modèle sur des cas inédits.
- Jeu de test : il sert à vérifier, après coup, que la couverture annoncée est bien obtenue.
Sur le jeu de calibration, on calcule pour chaque observation un score de non-conformité, c'est-à-dire un nombre qui mesure à quel point l'observation est « étrange » pour le modèle : plus le score est élevé, plus le modèle s'est trompé. On trie ensuite ces scores et on retient celui qui correspond au quantile voulu. Pour une couverture de 90 % et observations de calibration, on prend le quantile d'ordre avec , qui contient la légère correction « » nécessaire à la garantie.
Du seuil à la région de prédiction
Ce quantile, noté , devient un seuil. Pour une nouvelle observation, on inclut dans la région de prédiction toutes les valeurs dont le score de non-conformité reste inférieur ou égal à . Comme les observations de calibration et la nouvelle observation sont échangeables, le score de cette dernière a au moins 90 % de chances de se situer sous le seuil, d'où la garantie :
Cette garantie est dite marginale : elle porte sur la moyenne de l'ensemble des observations, et non sur chaque observation prise isolément. Un modèle peut ainsi être très précis sur certains profils et très incertain sur d'autres, tout en respectant globalement 90 % de couverture. C'est une nuance importante pour interpréter les résultats.
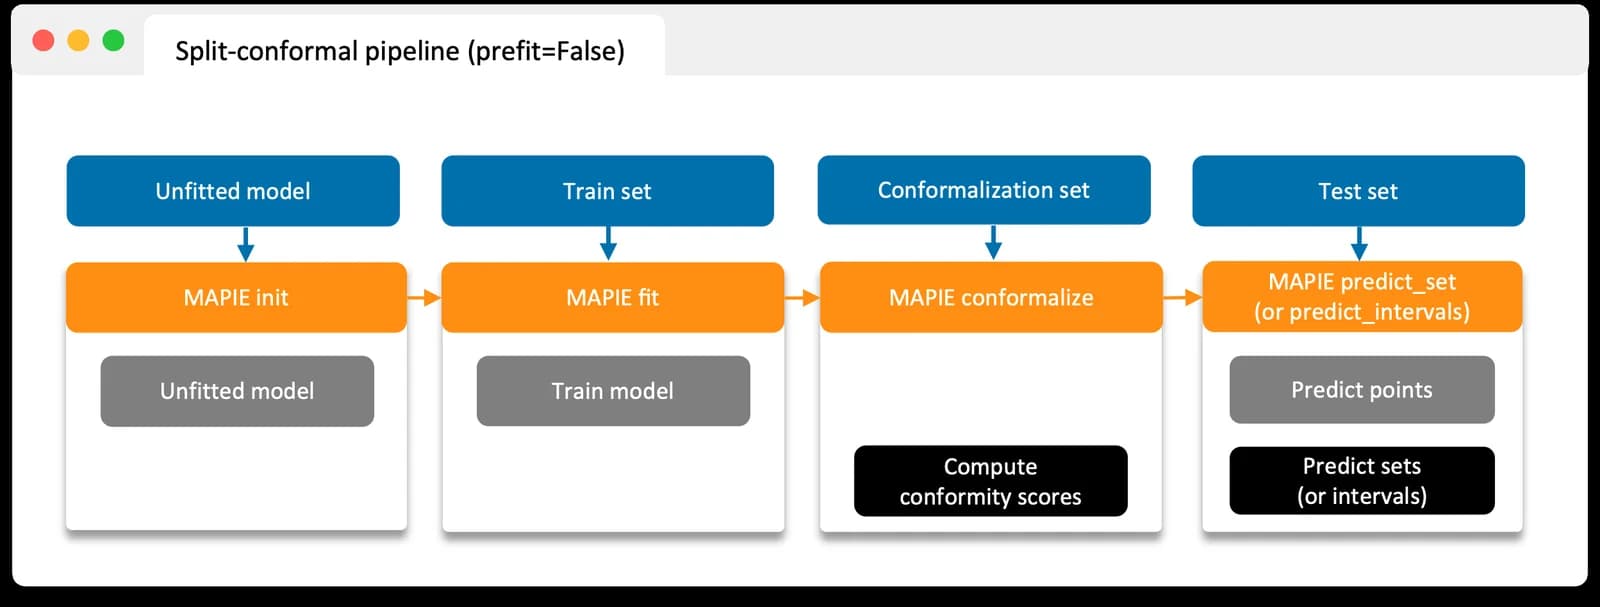
Le schéma ci-dessus, issu de la documentation de MAPIE, résume les étapes : le modèle est entraîné, le jeu de calibration sert à calculer les scores et le quantile, puis les prédictions sur le jeu de test sont accompagnées de leurs intervalles ou ensembles. Le coût supplémentaire est négligeable, puisqu'il se limite à un passage du modèle sur le jeu de calibration.
Régression et classification : deux scores différents
Le choix du score de non-conformité est le seul endroit où la méthode dépend de la tâche. Les garanties restent identiques, mais la forme de la région de prédiction et son efficacité changent.
En régression : des intervalles
Le score le plus simple est la valeur absolue du résidu : . Le seuil est alors le quantile de ces erreurs, et l'intervalle de prédiction est . Cette approche a un défaut : la largeur de l'intervalle est la même pour toutes les observations, alors que l'incertitude varie souvent selon la zone de l'espace des variables (hétéroscédasticité).
Pour y remédier, la variante Conformalized Quantile Regression (CQR) entraîne d'abord un modèle qui prédit directement des quantiles bas et haut, puis utilise le jeu de calibration pour corriger ces bornes. Les intervalles s'élargissent ainsi là où les données sont bruitées et se resserrent ailleurs, tout en gardant la garantie de couverture.
En classification : des ensembles de classes
En classification, la région de prédiction est un ensemble de classes. Deux scores sont très utilisés :
- LAC (Least Ambiguous set-valued Classifier) : le score est , où est la probabilité prédite pour la vraie classe. L'ensemble contient toutes les classes dont la probabilité dépasse un seuil. Il produit les ensembles les plus petits, mais peut parfois renvoyer un ensemble vide.
- APS (Adaptive Prediction Sets) : le score cumule les probabilités des classes classées par ordre décroissant jusqu'à atteindre la vraie classe. Les ensembles sont un peu plus grands, mais la couverture est mieux répartie entre les observations faciles et difficiles.
Un ensemble à une seule classe indique une prédiction fiable, tandis qu'un ensemble de trois classes signale un cas ambigu qu'il vaut mieux faire relire par un humain. La taille de l'ensemble devient ainsi une mesure directe de l'incertitude.
Comparaison des deux cas
Le tableau suivant résume les différences entre les deux tâches.
| Critère | Régression | Classification |
|---|---|---|
| Région de prédiction | Intervalle | Ensemble de classes |
| Score de non-conformité usuel | Résidu absolu, ou CQR | LAC ou APS |
| Mesure d'efficacité | Largeur moyenne de l'intervalle | Taille moyenne de l'ensemble |
| Signal d'incertitude | Intervalle large | Ensemble de plusieurs classes |
Dans les deux cas, la qualité d'une méthode se juge sur deux axes : la couverture (est-elle respectée ?) et l'efficacité (les régions sont-elles les plus petites possible ?). Un intervalle infini garantit la couverture sans servir à rien, d'où l'intérêt de bien choisir le modèle de base et le score.
Mise en pratique avec MAPIE
MAPIE (Model Agnostic Prediction Interval Estimator) est une bibliothèque Python open source, compatible avec l'API de scikit-learn et publiée sous licence BSD. Depuis la version 1.0, elle propose des classes dédiées, comme SplitConformalRegressor et SplitConformalClassifier, ainsi que les méthodes predict_interval et predict_set. Les exemples ci-dessous ont été testés avec la version 1.6.
pip install mapie scikit-learn
Un intervalle de prédiction en régression
Nous utilisons le jeu de données California Housing, avec une forêt aléatoire comme modèle de base. La fonction train_conformalize_test_split découpe les données en trois jeux, et la méthode conformalize calcule le seuil à partir du jeu de calibration.
import numpy as np
from sklearn.datasets import fetch_california_housing
from sklearn.ensemble import RandomForestRegressor
from mapie.regression import SplitConformalRegressor
from mapie.utils import train_conformalize_test_split

X, y = fetch_california_housing(return_X_y=True)

# Découpage en trois jeux : entraînement, calibration, test
X_train, X_conf, X_test, y_train, y_conf, y_test = train_conformalize_test_split(
    X, y, train_size=0.6, conformalize_size=0.2, test_size=0.2, random_state=42
)

# Couverture visée : 90 %
modele = SplitConformalRegressor(
    estimator=RandomForestRegressor(n_estimators=50, random_state=0, n_jobs=-1),
    confidence_level=0.9,
    prefit=False,
)
modele.fit(X_train, y_train)
modele.conformalize(X_conf, y_conf)

# Prédictions ponctuelles et intervalles
y_pred, y_intervals = modele.predict_interval(X_test)
bas, haut = y_intervals[:, 0, 0], y_intervals[:, 1, 0]

couverture = np.mean((y_test >= bas) & (y_test <= haut))
largeur = np.mean(haut - bas)
print(f"Couverture : {couverture:.3f}, largeur moyenne : {largeur:.2f}")
Sur notre exécution, la couverture mesurée sur le jeu de test est d'environ 0,90, conforme à la cible, pour une largeur moyenne d'environ 1,64 (la cible est exprimée en centaines de milliers de dollars). Le tableau y_intervals a la forme (n_observations, 2, n_niveaux_de_confiance), ce qui permet de demander plusieurs niveaux de confiance en une seule fois en passant une liste à confidence_level.
Des ensembles de prédiction en classification
Pour la classification, la logique est identique, avec un score à choisir via le paramètre conformity_score et une méthode predict_set qui renvoie, pour chaque observation, un masque booléen indiquant les classes retenues.
from sklearn.datasets import load_wine
from sklearn.ensemble import RandomForestClassifier
from mapie.classification import SplitConformalClassifier
from mapie.utils import train_conformalize_test_split

X, y = load_wine(return_X_y=True)
X_train, X_conf, X_test, y_train, y_conf, y_test = train_conformalize_test_split(
    X, y, train_size=0.5, conformalize_size=0.3, test_size=0.2, random_state=42
)

classifieur = SplitConformalClassifier(
    estimator=RandomForestClassifier(random_state=0),
    confidence_level=0.9,
    conformity_score="lac",  # ou "aps" pour des ensembles adaptatifs
    prefit=False,
)
classifieur.fit(X_train, y_train)
classifieur.conformalize(X_conf, y_conf)

y_pred, y_sets = classifieur.predict_set(X_test)
# y_sets : tableau booléen de forme (n_observations, n_classes, n_niveaux)
tailles = y_sets[:, :, 0].sum(axis=1)
vraies_classes_incluses = y_sets[np.arange(len(y_test)), y_test, 0]
print(f"Couverture : {vraies_classes_incluses.mean():.3f}")
print(f"Taille moyenne des ensembles : {tailles.mean():.2f}")
Le jeu de test étant ici très petit (36 observations), la couverture mesurée fluctue autour de la cible : la garantie porte sur la moyenne, pas sur chaque tirage. Si le modèle est déjà entraîné, il suffit de passer prefit=True (valeur par défaut) et d'appeler uniquement conformalize. La bibliothèque est aussi compatible avec un pipeline scikit-learn, ce qui permet d'inclure le prétraitement dans le modèle de base.
Limites et bonnes pratiques
La prédiction conforme n'est pas une solution magique, et quelques précautions s'imposent avant de l'utiliser en production.
- Échangeabilité : la garantie suppose que les données futures ressemblent à celles de calibration. En cas de dérive des données (drift), la couverture réelle peut chuter. Il faut surveiller la couverture observée en production et recalibrer régulièrement.
- Couverture marginale : la garantie ne vaut pas pour chaque sous-groupe. Sur des populations sensibles, vérifiez la couverture par segment, ou recourez à des méthodes conditionnelles comme la prédiction conforme de type Mondrian, qui calibre séparément chaque groupe.
- Taille du jeu de calibration : avec peu d'observations, le quantile est instable et la couverture varie fortement. Quelques centaines d'exemples constituent un minimum raisonnable pour un niveau de 90 %.
- Qualité du modèle de base : la méthode ne corrige pas un mauvais modèle, elle le rend simplement honnête. Un modèle peu précis produit des intervalles larges ou des ensembles volumineux. Il reste donc nécessaire d'éviter le surapprentissage et de bien choisir ses variables.
- Coût en données : le split réserve une part des données à la calibration. Les variantes par validation croisée (cross-conformal) ou par jackknife+ limitent cette perte, au prix d'un calcul plus long.
Côté usage, la prédiction conforme complète les approches d'interprétabilité : l'une explique pourquoi le modèle prédit, l'autre indique avec quelle fiabilité. Elle s'applique aussi aux modèles récents, y compris aux modèles de fondation pour données tabulaires, pour lesquels elle apporte une couche de garantie sans réentraînement.
À découvrir : notre formation Data Scientist
Conclusion
La prédiction conforme répond à une question simple que les modèles de Machine Learning laissent le plus souvent sans réponse : dans quelle mesure peut-on se fier à cette prédiction ? En mesurant les erreurs du modèle sur un jeu de calibration, elle construit des intervalles en régression et des ensembles de classes en classification, avec une garantie de couverture valable en échantillon fini et sans hypothèse sur la distribution des données.
Sa force tient à sa généralité et à sa simplicité de mise en œuvre. Elle s'ajoute à n'importe quel modèle existant, ne demande qu'un jeu de calibration et se déploie en quelques lignes grâce à MAPIE. Ses limites, l'échangeabilité des données et la nature marginale de la garantie, imposent néanmoins de surveiller la couverture réelle une fois le modèle en production.
Dans des domaines comme la santé, la finance ou l'assurance, où une prédiction erronée a un coût élevé, savoir quantifier l'incertitude devient une compétence différenciante pour un Data Scientist. La prédiction conforme en est l'un des outils les plus accessibles, et son adoption progresse à mesure que les équipes cherchent à rendre leurs modèles non seulement performants, mais aussi dignes de confiance.