Mixture of Experts : comprendre l'architecture des LLM modernes
Qwen3, DeepSeek-V3, Mistral Large 3, gpt-oss : la plupart des LLM open weights récents affichent des centaines de milliards de paramètres, mais se comportent à l'usage comme des modèles bien plus petits. Cette apparente contradiction tient à une architecture désormais omniprésente, le Mixture of Experts, qui n'active à chaque token qu'une fraction du réseau.
Équipe Blent
Publié le · 13 min de lecture
Dans cet article
Qwen3, DeepSeek-V3, Mistral Large 3, gpt-oss : la plupart des LLM open weights récents affichent des centaines de milliards de paramètres, mais se comportent à l'usage comme des modèles bien plus petits. Cette apparente contradiction tient à une architecture désormais omniprésente, le Mixture of Experts, qui n'active à chaque token qu'une fraction du réseau.
Le principe n'est pas nouveau : il remonte aux travaux de Jacobs et Hinton au début des années 1990, puis à l'adaptation aux réseaux profonds par Google (GShard, Switch Transformers). Il s'est démocratisé avec Mixtral en 2023 et s'est imposé comme le standard des modèles de pointe, au point qu'un développeur qui déploie un LLM open weights a aujourd'hui de fortes chances de manipuler un modèle MoE sans le savoir.
Or cette architecture change profondément les règles de l'inférence. Un modèle MoE est rapide comme un petit modèle, mais gourmand en mémoire comme un grand. Dans cet article, nous allons expliquer le fonctionnement du routeur et du top-k, clarifier la différence entre paramètres totaux et paramètres actifs, voir comment les experts sont équilibrés pendant l'entraînement, puis détailler les conséquences concrètes pour la mémoire GPU, la quantization et le serving avec vLLM.
Qu'est-ce qu'un Mixture of Experts ?
Un Transformer classique est composé de blocs identiques qui contiennent chacun une couche d'attention et un réseau feed-forward (FFN). Dans un modèle dense, tous les paramètres de ce FFN sont utilisés pour chaque token, quelle que soit la nature du texte. Or le FFN concentre la majorité des paramètres du modèle, et donc l'essentiel du coût de calcul.
L'architecture Mixture of Experts (MoE, ou mélange d'experts) remplace ce FFN unique par un ensemble de plusieurs FFN indépendants, appelés experts, et par un petit réseau appelé routeur (gating network). Pour chaque token, le routeur choisit quelques experts à solliciter, les autres restent inactifs. On parle de modèle sparse (creux), par opposition au modèle dense.
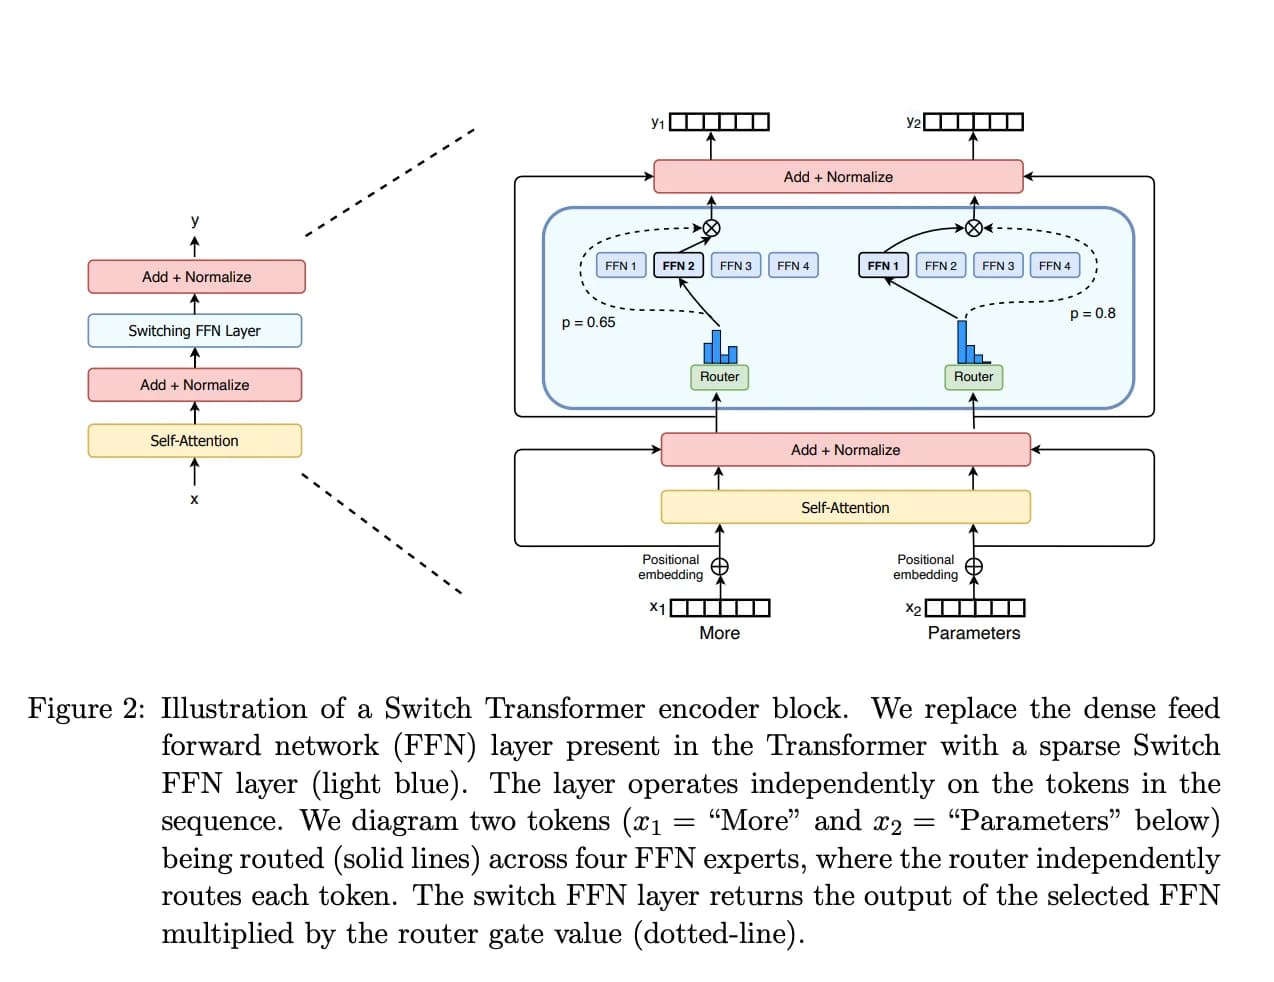
Deux précisions évitent des contresens fréquents :
- Les experts ne sont pas des spécialistes thématiques : on ne trouve pas un expert « code », un expert « droit » et un expert « cuisine ». Les analyses montrent plutôt des spécialisations sur des motifs syntaxiques ou lexicaux, par exemple la ponctuation ou certaines catégories de tokens
- Le MoE ne concerne que les FFN : l'attention reste partagée par tous les tokens, et chaque couche du modèle possède son propre ensemble d'experts et son propre routeur
Le choix est donc fait token par token et couche par couche. Deux tokens consécutifs d'une même phrase peuvent être traités par des experts différents, et un même token traverse des experts différents à chaque couche.
Le routeur et le top-k
Le routeur est étonnamment simple : une projection linéaire qui transforme la représentation d'un token en un score par expert. On applique ensuite un softmax pour obtenir une distribution de probabilité, puis on ne conserve que les k meilleurs scores. C'est le mécanisme du top-k.
La sortie de la couche est la somme des sorties des k experts sélectionnés, pondérées par leurs scores normalisés. Pour un token , avec le -ème expert et son poids de routage :
Voici une implémentation minimale en PyTorch qui montre ce mécanisme :
import torch
import torch.nn as nn
import torch.nn.functional as F


class MoELayer(nn.Module):
    """Couche MoE simplifiée : un routeur et plusieurs experts FFN."""

    def __init__(self, dim=512, hidden=2048, n_experts=8, top_k=2):
        super().__init__()
        self.top_k = top_k
        # Le routeur produit un score par expert
        self.router = nn.Linear(dim, n_experts, bias=False)
        self.experts = nn.ModuleList(
            nn.Sequential(nn.Linear(dim, hidden), nn.SiLU(), nn.Linear(hidden, dim))
            for _ in range(n_experts)
        )

    def forward(self, x):  # x : (n_tokens, dim)
        scores = F.softmax(self.router(x), dim=-1)
        # On garde les k meilleurs experts pour chaque token
        weights, indices = scores.topk(self.top_k, dim=-1)
        weights = weights / weights.sum(dim=-1, keepdim=True)

        out = torch.zeros_like(x)
        for i, expert in enumerate(self.experts):
            # Tokens pour lesquels l'expert i figure dans le top-k
            token_idx, slot = (indices == i).nonzero(as_tuple=True)
            if token_idx.numel() > 0:
                out[token_idx] += weights[token_idx, slot, None] * expert(x[token_idx])
        return out
Dans cet exemple, chaque token traverse seulement 2 experts sur 8, soit un quart du FFN. Les implémentations de production utilisent des noyaux GPU dédiés plutôt qu'une boucle Python, mais la logique est identique.
Les modèles récents ont évolué vers des experts plus nombreux et plus petits (on parle d'experts à grain fin), avec un top-k plus élevé. Certains ajoutent aussi un expert partagé, toujours actif, qui capte les connaissances communes pour laisser les experts routés se spécialiser. Le tableau suivant compare quelques modèles représentatifs.
| Modèle | Experts routés | Experts actifs par token | Paramètres totaux | Paramètres actifs |
|---|---|---|---|---|
| Mixtral 8x7B | 8 | 2 | 46,7 Md | 12,9 Md |
| Qwen3-235B-A22B | 128 | 8 | 235 Md | 22 Md |
| DeepSeek-V3 | 256 (+1 partagé) | 8 | 671 Md | 37 Md |
| gpt-oss-120b | 128 | 4 | 117 Md | 5,1 Md |
On constate que la tendance va vers des ratios de plus en plus extrêmes : gpt-oss-120b n'active qu'environ 4 % de ses paramètres à chaque token, là où Mixtral en activait près de 28 %.
Paramètres totaux et paramètres actifs
Cette distinction est la clé pour comprendre le MoE. Les paramètres totaux désignent l'ensemble des poids du modèle, experts inclus. Les paramètres actifs correspondent à ceux effectivement utilisés pour traiter un token : l'attention, les experts sélectionnés, l'expert partagé et le routeur.
Cette différence est visible dans la nomenclature de certains modèles : « A22B » dans Qwen3-235B-A22B signifie 22 milliards de paramètres actifs. Les deux chiffres répondent à deux questions distinctes :
- Le coût de calcul dépend des paramètres actifs : un modèle de 235 milliards de paramètres dont 22 sont actifs calcule à peu près comme un modèle dense de 22 milliards
- L'empreinte mémoire dépend des paramètres totaux : tous les experts doivent être chargés en mémoire GPU, puisque n'importe lequel peut être appelé au token suivant
- La capacité de connaissance se rapproche de celle d'un grand modèle, car les experts stockent collectivement beaucoup plus d'information qu'un petit modèle dense
Le MoE permet ainsi de dépasser un compromis classique : pour un budget de calcul donné à l'entraînement comme à l'inférence, on obtient un modèle plus capable. C'est ce qui explique son adoption massive pour les modèles de pointe, y compris les modèles de raisonnement qui génèrent de très longues réponses et pour lesquels le coût par token est déterminant.
Équilibrer la charge entre experts
Un routeur entraîné sans précaution a tendance à s'effondrer : quelques experts reçoivent presque tous les tokens, progressent plus vite, et sont donc encore davantage choisis. Les autres restent sous-entraînés, ce qui gaspille des paramètres. Ce phénomène est appelé effondrement du routage (routing collapse).
La perte auxiliaire d'équilibrage
La solution historique consiste à ajouter à la fonction de perte un terme d'équilibrage de charge (load balancing loss), introduit dans les Switch Transformers. Il pénalise un routage inégal en comparant, pour chaque expert, la fraction de tokens qui lui est envoyée et la probabilité moyenne que lui attribue le routeur. L'optimum est atteint lorsque les tokens sont répartis uniformément.
Cette approche a un coût : en tirant le routeur vers l'uniformité, la perte auxiliaire peut dégrader la qualité du modèle. Elle impose donc de régler finement son coefficient, ni trop faible pour éviter l'effondrement, ni trop fort pour ne pas brider la spécialisation.
Capacité des experts et variantes récentes
Pendant l'entraînement, certaines implémentations fixent une capacité maximale par expert, c'est-à-dire un nombre de tokens qu'il peut recevoir par batch. Les tokens excédentaires sont abandonnés (token dropping) ou redirigés. D'autres approches, comme celle des noyaux block-sparse, évitent cette contrainte en traitant des experts avec des charges variables.
DeepSeek-V3 a proposé une alternative : un équilibrage sans perte auxiliaire. Un biais est ajouté aux scores de chaque expert uniquement pour la sélection du top-k, et ajusté dynamiquement : il diminue pour un expert surchargé et augmente pour un expert sous-utilisé. Les poids de pondération restent calculés sans ce biais, ce qui évite de perturber l'apprentissage. Cette technique est désormais reprise par d'autres familles de modèles.
L'équilibrage ne concerne pas seulement l'entraînement. En production, la répartition des tokens entre experts détermine aussi l'utilisation réelle des GPU, comme nous allons le voir.
Conséquences pour l'inférence
Pour un développeur ou un data scientist qui déploie un modèle MoE, les paramètres totaux et actifs se traduisent directement en contraintes d'infrastructure. Le tableau suivant résume les effets principaux par rapport à un modèle dense de taille comparable aux paramètres actifs.
| Ressource | Modèle dense (taille actifs) | Modèle MoE | Explication |
|---|---|---|---|
| Mémoire GPU (poids) | Faible | Élevée | Tous les experts sont chargés |
| Calcul par token | Faible | Faible | Seuls les experts actifs sont calculés |
| Débit à forte charge | Correct | Très bon | Peu de calcul par token |
| Latence à faible charge | Bonne | Variable | Plus de poids différents à lire |
Mémoire GPU et débit
La mémoire nécessaire pour stocker les poids se calcule à partir des paramètres totaux. DeepSeek-V3, avec 671 milliards de paramètres, occupe environ 1,3 To en BF16 et environ 670 Go en FP8, ce qui impose un serveur multi-GPU même si seuls 37 milliards de paramètres sont utilisés par token. S'y ajoute le KV cache, qui dépend de l'attention et du contexte, pas du nombre d'experts.
Côté performance, l'inférence en phase de decode est limitée par la bande passante mémoire (voir notre article sur le speculative decoding). Avec un MoE, un seul token ne lit que les experts actifs, mais un batch de plusieurs requêtes sollicite des experts différents : plus le batch grossit, plus la proportion d'experts à lire s'approche de la totalité. Le MoE est donc particulièrement avantageux à forte charge, où le calcul économisé se traduit en débit, et moins spectaculaire pour une requête isolée sur un GPU unique.
Quantization
Comme la mémoire est le principal facteur limitant, la quantization est encore plus précieuse sur les modèles MoE. Les experts représentent la grande majorité des poids, ce qui permet de ne quantizer qu'eux de manière agressive tout en laissant l'attention en précision supérieure. C'est l'approche retenue pour gpt-oss, dont les poids des experts sont publiés en MXFP4 (environ 4 bits par paramètre) : gpt-oss-120b tient ainsi sur un seul GPU de 80 Go, et gpt-oss-20b sur une machine de 16 Go de mémoire.
La contrepartie est que la quantization peut modifier légèrement les scores du routeur, et donc le choix des experts. Il est recommandé de garder le routeur en haute précision et de valider le modèle quantizé sur vos propres cas d'usage, plutôt que de se fier uniquement aux benchmarks publics.
À découvrir : notre formation LLM Engineering
Serving avec vLLM
vLLM prend en charge les principaux modèles MoE avec des noyaux dédiés. Sur un modèle qui ne tient pas sur un seul GPU, deux stratégies de parallélisme se combinent : le tensor parallelism, qui découpe chaque matrice entre les GPU, et l'expert parallelism, qui répartit les experts entiers sur des GPU différents. Dans ce second cas, un token est envoyé vers le GPU qui héberge l'expert choisi, puis le résultat revient, ce qui génère des communications entre GPU.
# Serveur d'un modèle MoE sur 8 GPU avec parallélisme d'experts
vllm serve Qwen/Qwen3-235B-A22B-FP8 \
    --tensor-parallel-size 8 \
    --enable-expert-parallel \
    --max-model-len 32768 \
    --gpu-memory-utilization 0.9
L'option --enable-expert-parallel active la répartition des experts entre GPU, au lieu de découper les poids de chaque expert. Le choix entre les deux dépend du modèle, de la topologie réseau (NVLink ou non) et du profil de trafic : les noms d'options évoluent d'une version à l'autre, il faut donc se référer à la documentation de la version installée. Un déséquilibre de routage se paie alors directement : si un expert très sollicité réside sur un GPU, les autres l'attendent. Il est donc utile de surveiller la répartition de la charge et de mesurer le débit sous trafic réaliste.
Quelques bonnes pratiques résument les choix de déploiement :
- Dimensionner sur les paramètres totaux : prévoir la mémoire pour tous les experts, plus le KV cache et une marge de sécurité
- Privilégier un modèle déjà quantizé : les versions FP8 ou 4 bits divisent le nombre de GPU nécessaires
- Tester les deux modes de parallélisme : tensor parallelism seul ou combiné à l'expert parallelism, selon l'interconnexion disponible
- Mesurer à plusieurs niveaux de concurrence : l'avantage du MoE se révèle surtout à forte charge, ce qui est essentiel pour estimer le coût réel dans une démarche de FinOps pour les LLM
Quand choisir un modèle MoE ?
Les modèles MoE sont aujourd'hui le choix par défaut dès que l'on vise la meilleure qualité possible pour un coût d'inférence donné, en particulier pour un service à forte concurrence. En revanche, un small language model dense reste souvent plus simple à déployer sur un seul GPU ou sur un poste de développeur, car il évite la complexité du multi-GPU et le surcoût mémoire des experts inutilisés.
Le fine-tuning mérite aussi une attention particulière : les modèles MoE sont plus délicats à adapter, car il faut éviter de déséquilibrer le routage, et leur empreinte mémoire est celle du modèle total. Beaucoup d'équipes préfèrent donc des adaptateurs légers, ou le fine-tuning d'un modèle dense plus petit lorsque la tâche est étroite.
Conclusion
Le Mixture of Experts repose sur une idée simple : ne mobiliser, pour chaque token, que les experts utiles plutôt que l'ensemble du réseau. Grâce au routeur et au top-k, les modèles gagnent en capacité sans que le coût de calcul n'augmente dans les mêmes proportions, ce qui explique leur domination sur les modèles open weights récents.
Pour qui déploie ces modèles, la distinction entre paramètres totaux et paramètres actifs est la grille de lecture essentielle : le calcul suit les actifs, la mémoire suit les totaux. Elle guide le dimensionnement des GPU, le choix de la quantization et la stratégie de parallélisme dans vLLM, et rappelle qu'un équilibrage de charge imparfait se paie en latence.
À mesure que les experts deviennent plus nombreux, plus fins et plus fortement quantizés, comprendre l'architecture interne des modèles devient une compétence différenciante. Savoir lire une fiche de modèle, estimer son empreinte et arbitrer entre parallélismes fait désormais partie du quotidien d'un ingénieur qui sert des LLM en production.