Apache Iceberg : le format de table ouvert du lakehouse
Comment stocker des pétaoctets de données dans un Data Lake tout en conservant les garanties d'une base de données : transactions, évolution de schéma, retour en arrière ? Comment éviter de dépendre d'un seul moteur de calcul ou d'un seul éditeur ? Pendant des années, empiler des fichiers Parquet dans un stockage objet a imposé de renoncer à ces garanties. Les formats de table ouverts, et en tête Apache Iceberg, ont été conçus pour lever ce compromis.
Équipe Blent
Publié le · 10 min de lecture
Dans cet article
Comment stocker des pétaoctets de données dans un Data Lake tout en conservant les garanties d'une base de données : transactions, évolution de schéma, retour en arrière ? Comment éviter de dépendre d'un seul moteur de calcul ou d'un seul éditeur ? Pendant des années, empiler des fichiers Parquet dans un stockage objet a imposé de renoncer à ces garanties. Les formats de table ouverts, et en tête Apache Iceberg, ont été conçus pour lever ce compromis.
Né chez Netflix et confié à la fondation Apache en 2018, Iceberg est aujourd'hui devenu le format de table de référence du lakehouse, cette architecture qui combine la souplesse d'un Data Lake et la fiabilité d'un Data Warehouse. Sa spécification v3, désormais prise en charge par des plateformes comme Snowflake ou Databricks, ajoute des fonctionnalités majeures : deletion vectors, row lineage et type VARIANT.
Dans cet article, nous allons d'abord comprendre ce qu'est Apache Iceberg et comment son architecture de métadonnées fonctionne, puis voir le rôle des catalogues REST comme Apache Polaris. Nous mettrons ensuite en pratique le format avec PySpark, avant de le comparer à Delta Lake.
Qu'est-ce qu'Apache Iceberg ?
Apache Iceberg est une spécification de format de table ouvert pour de très grands jeux de données analytiques. Iceberg ne stocke pas de données lui-même et n'est pas un moteur de calcul : il décrit comment organiser des fichiers de données (le plus souvent au format Parquet) et leurs métadonnées dans un stockage objet comme Amazon S3, Google Cloud Storage ou MinIO, afin qu'ils se comportent comme une véritable table.
Avec de simples fichiers Parquet dans un dossier, plusieurs problèmes reviennent systématiquement : une lecture pendant une écriture peut voir des données incomplètes, le renommage d'une colonne oblige à réécrire les fichiers, et lister des millions d'objets pour planifier une requête devient très lent. Iceberg répond à ces limites avec plusieurs propriétés :
- Transactions ACID : chaque écriture est validée de manière atomique, les lecteurs voient toujours un état cohérent de la table.
- Évolution de schéma sûre : ajout, suppression, renommage ou réordonnancement de colonnes sans réécrire les données.
- Time travel : lecture de la table telle qu'elle était à un instant donné, et retour en arrière en cas d'erreur.
- Partitionnement caché : la table gère elle-même la transformation de partition (jour, mois, hachage), sans que les utilisateurs aient à filtrer sur une colonne de partition dédiée.
- Interopérabilité : une même table est lisible par Apache Spark, Flink, Trino, Snowflake ou DuckDB, sans copie des données.
Cette dernière propriété est la plus stratégique pour les entreprises. En stockant ses tables au format Iceberg dans son propre stockage objet, une organisation conserve la maîtrise de ses données et peut changer de moteur de calcul sans migration.
Architecture : métadonnées, snapshots et manifestes
La force d'Iceberg réside dans sa structure de métadonnées arborescente, qui permet à un moteur de savoir exactement quels fichiers lire sans jamais lister un dossier.
Les couches de métadonnées
Une table Iceberg s'organise en plusieurs niveaux, du plus haut au plus bas :
- Le fichier de métadonnées (JSON) décrit l'état courant de la table : schéma, spécification de partitionnement, propriétés et liste des snapshots.
- Chaque snapshot représente l'état complet de la table à un instant donné et pointe vers une liste de manifestes.
- Les fichiers manifest list et manifest recensent les fichiers de données avec leurs statistiques (valeurs minimales et maximales par colonne, nombre de lignes), ce qui permet d'éliminer des fichiers entiers lors de la planification d'une requête.
- Les fichiers de données contiennent les lignes, en Parquet, ORC ou Avro.
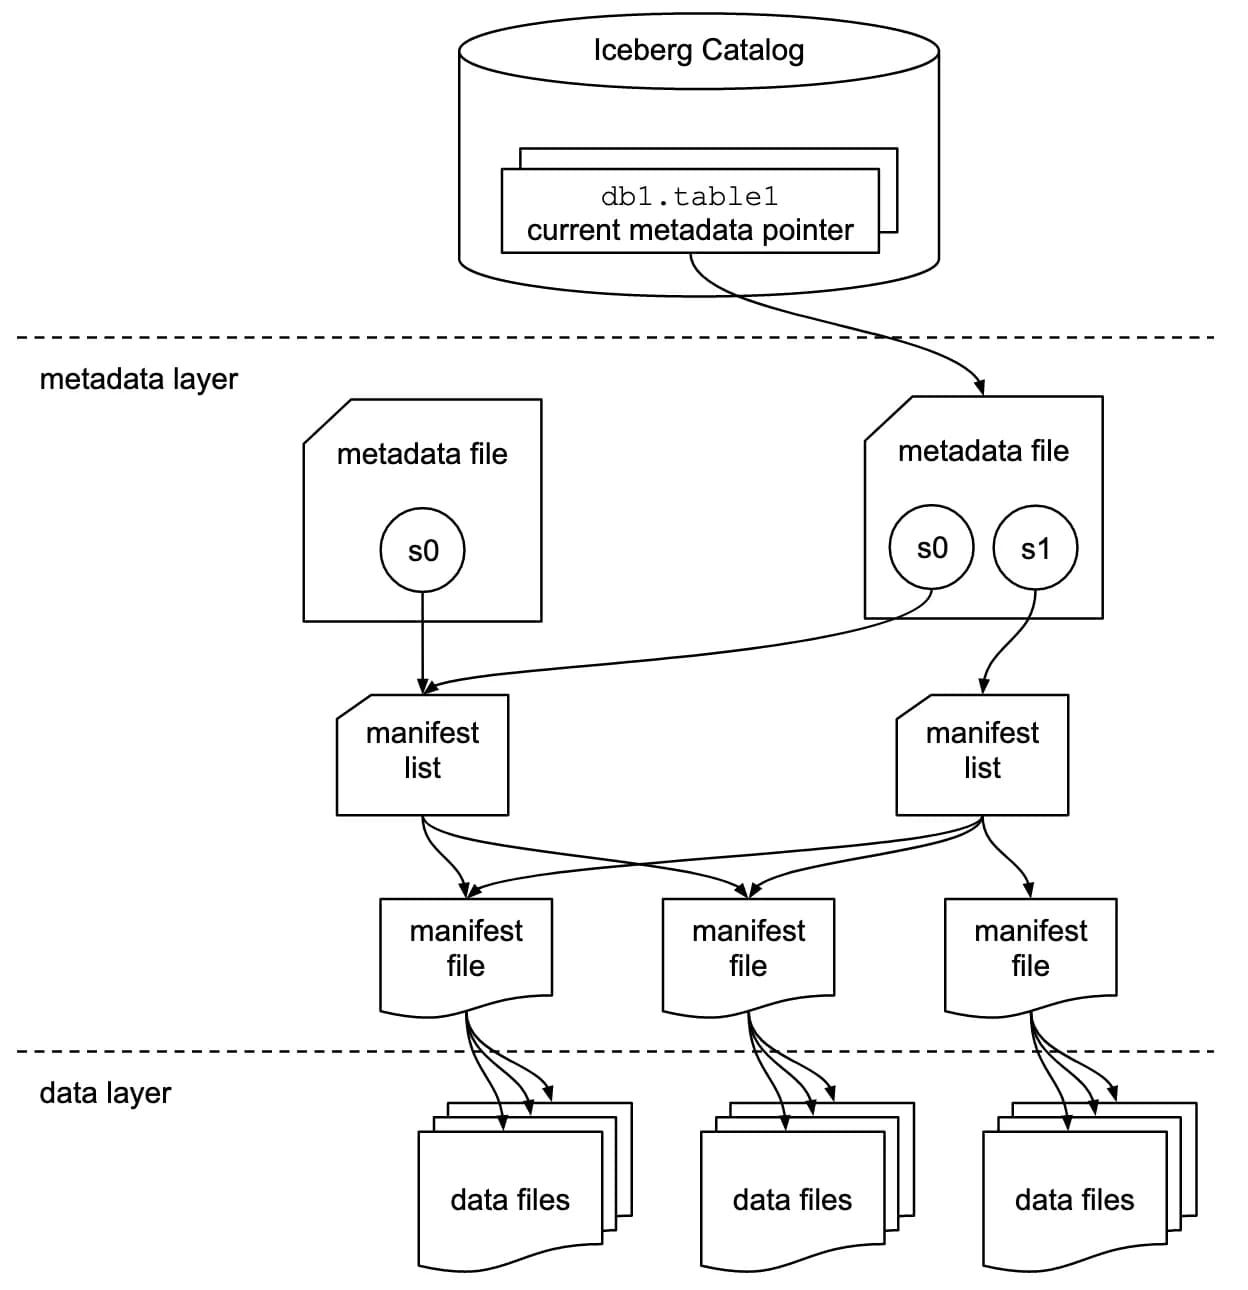
Lorsqu'une écriture est validée, Iceberg produit de nouveaux fichiers de métadonnées puis remplace de façon atomique le pointeur de la table dans le catalogue. Tant que ce remplacement n'a pas eu lieu, les lecteurs continuent de voir l'ancien snapshot. C'est ce mécanisme d'isolation par snapshots qui garantit la cohérence, et qui rend possibles le time travel et le retour en arrière.
Time travel et évolution de schéma
Chaque snapshot étant conservé tant qu'il n'est pas expiré, il est possible d'interroger la table à n'importe quel moment de son historique. Pour l'évolution de schéma, Iceberg suit les colonnes par identifiant unique et non par nom ou par position. Renommer une colonne ne modifie donc que les métadonnées, et une colonne supprimée puis recréée ne ressuscite jamais d'anciennes valeurs par erreur.
Suppressions et mises à jour au niveau des lignes
Les fichiers Parquet étant immuables, supprimer une ligne demande un mécanisme dédié. Deux stratégies coexistent : la réécriture complète des fichiers concernés (copy-on-write) et l'enregistrement séparé des suppressions (merge-on-read), qui sont appliquées à la lecture. La spécification v2 utilisait pour cela des fichiers de suppression, dont la multiplication pénalisait les lectures.
La spécification v3
La version 3 de la spécification, disponible en production depuis Apache Iceberg 1.10, apporte plusieurs évolutions attendues par les équipes data. Les trois plus structurantes sont les suivantes :
- Les deletion vectors remplacent les fichiers de suppression par position. Les lignes supprimées d'un fichier de données sont encodées dans un bitmap compact, stocké dans un fichier Puffin. Les lectures sont plus rapides et la maintenance des tables plus simple.
- Le row lineage attribue à chaque ligne un identifiant stable et enregistre la dernière modification (champs
_row_idet_last_updated_sequence_number). Il devient possible de calculer proprement les changements d'une table, ce qui facilite les pipelines incrémentaux. - Le type VARIANT stocke des données semi-structurées (JSON) sous une forme binaire efficace, sans imposer de schéma rigide à l'ingestion.
La v3 introduit aussi des valeurs par défaut pour les colonnes, des horodatages à la nanoseconde et des types géospatiaux. L'adoption progresse chez les éditeurs : Snowflake et Databricks prennent en charge ces fonctionnalités, tandis que BigQuery sait lire des tables Iceberg v3 avec deletion vectors, l'écriture passant par un moteur ouvert comme Spark, Flink ou Trino. Le support restant inégal selon les plateformes et les versions, il faut vérifier la compatibilité de chaque moteur avant de passer une table en format-version 3. Côté Databricks, ces fonctionnalités demandent par exemple une version récente du runtime et Unity Catalog.
Les catalogues REST et Apache Polaris
Pour retrouver une table, un moteur a besoin d'un catalogue, qui associe le nom d'une table à l'emplacement de son fichier de métadonnées courant. Historiquement, chaque moteur disposait de ses propres implémentations (Hive Metastore, AWS Glue, JDBC), ce qui compliquait l'interopérabilité.
La spécification Iceberg REST Catalog standardise cette interaction via une API HTTP. Tout moteur qui parle ce protocole peut dialoguer avec n'importe quel catalogue compatible : création de tables, validation des transactions, gestion des espaces de noms et distribution d'identifiants temporaires pour accéder au stockage (credential vending).
Apache Polaris est l'implémentation open source de référence de ce protocole. Co-créé par Snowflake et Dremio puis donné à la fondation Apache en 2024, le projet est devenu un projet Apache de premier niveau en 2026. Il gère l'authentification, les rôles et les permissions d'accès aux tables, et est compatible avec Spark, Flink, Trino, Dremio ou StarRocks. D'autres catalogues implémentent la même API, comme Unity Catalog, Nessie ou Lakekeeper.
Mise en pratique avec PySpark
Voyons comment utiliser Iceberg depuis PySpark avec un catalogue REST. Nous configurons une session Spark qui pointe vers un catalogue Polaris, puis nous créons une table au format v3 :
from pyspark.sql import SparkSession

# Session Spark avec le runtime Iceberg et un catalogue REST (Polaris)
spark = (
    SparkSession.builder.appName("iceberg-demo")
    .config("spark.jars.packages", "org.apache.iceberg:iceberg-spark-runtime-3.5_2.12:1.10.0")
    .config("spark.sql.extensions", "org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions")
    .config("spark.sql.catalog.lakehouse", "org.apache.iceberg.spark.SparkCatalog")
    .config("spark.sql.catalog.lakehouse.type", "rest")
    .config("spark.sql.catalog.lakehouse.uri", "http://localhost:8181/api/catalog")
    .config("spark.sql.catalog.lakehouse.warehouse", "blent")
    .config("spark.sql.catalog.lakehouse.credential", "client_id:client_secret")
    .config("spark.sql.catalog.lakehouse.scope", "PRINCIPAL_ROLE:ALL")
    .getOrCreate()
)

# Création d'une table partitionnée par jour, au format v3
spark.sql("""
    CREATE TABLE IF NOT EXISTS lakehouse.ventes.commandes (
        id BIGINT,
        client STRING,
        montant DOUBLE,
        date_commande TIMESTAMP
    )
    USING iceberg
    PARTITIONED BY (days(date_commande))
    TBLPROPERTIES ('format-version' = '3', 'write.delete.mode' = 'merge-on-read')
""")

spark.sql("INSERT INTO lakehouse.ventes.commandes VALUES (1, 'Alice', 120.0, current_timestamp())")
Le partitionnement days(date_commande) est une transformation cachée : les requêtes filtrant sur date_commande en profitent automatiquement. Les propriétés format-version et write.delete.mode activent respectivement la spécification v3 et les suppressions de type merge-on-read. Une fois la table alimentée, on peut inspecter son historique, faire évoluer son schéma et remonter dans le temps :
# Historique des snapshots via les tables de métadonnées
spark.sql("SELECT snapshot_id, committed_at, operation FROM lakehouse.ventes.commandes.snapshots").show()

# Évolution de schéma : opération sur les métadonnées uniquement
spark.sql("ALTER TABLE lakehouse.ventes.commandes ADD COLUMN pays STRING")
spark.sql("ALTER TABLE lakehouse.ventes.commandes RENAME COLUMN client TO nom_client")

# Time travel : lecture de la table à un snapshot précédent
spark.sql("SELECT * FROM lakehouse.ventes.commandes VERSION AS OF 123456789").show()

# Retour en arrière en cas d'erreur de traitement
spark.sql("CALL lakehouse.system.rollback_to_snapshot('ventes.commandes', 123456789)")
Chaque opération crée un nouveau snapshot visible dans la table snapshots. L'identifiant 123456789 est ici fictif : on le remplace par un identifiant réel issu de cette table. La procédure rollback_to_snapshot ne supprime aucune donnée, elle fait simplement pointer la table vers un ancien état. Pour limiter la taille des métadonnées, il faut ensuite planifier une maintenance régulière : compaction des petits fichiers (rewrite_data_files) et expiration des anciens snapshots (expire_snapshots).
À découvrir : notre formation Data Engineer
Iceberg face à Delta Lake
Iceberg n'est pas le seul format de table ouvert. Delta Lake, créé par Databricks, repose sur un principe voisin : un journal de transactions (_delta_log) enregistre les modifications apportées à des fichiers Parquet. Les deux formats offrent transactions ACID, time travel et évolution de schéma, et leurs fonctionnalités tendent à converger (Delta propose lui aussi des deletion vectors). Les différences portent surtout sur la gouvernance et l'écosystème.
| Critère | Apache Iceberg | Delta Lake |
|---|---|---|
| Gouvernance | Fondation Apache, spécification indépendante | Projet de la Linux Foundation, historiquement piloté par Databricks |
| Métadonnées | Arbre de snapshots et manifestes | Journal de transactions JSON et checkpoints |
| Partitionnement | Partitionnement caché, évolution du partitionnement | Partitionnement explicite, clustering liquide |
| Catalogue | API REST standardisée | Unity Catalog, métastores Hive ou Glue |
| Support multi-moteurs | Très large (Spark, Flink, Trino, Snowflake, BigQuery) | Large, historiquement centré sur Spark et Databricks |
Ce comparatif montre qu'Iceberg a pris l'avantage sur l'ouverture et la neutralité vis-à-vis des éditeurs, tandis que Delta Lake reste très solide dans les environnements centrés sur Databricks. Le choix dépend donc surtout du contexte : une organisation multi-moteurs privilégiera Iceberg, une équipe entièrement sur Databricks pourra rester sur Delta. Des couches de compatibilité, comme UniForm côté Delta, permettent d'ailleurs d'exposer une même table dans les deux formats, ce qui réduit le risque d'un choix définitif.
Conclusion
Apache Iceberg a transformé de simples fichiers dans un stockage objet en tables fiables, versionnées et interopérables. Son architecture de métadonnées, fondée sur les snapshots et les manifestes, apporte les transactions, le time travel et l'évolution de schéma qui manquaient aux Data Lakes, tout en évitant l'enfermement chez un éditeur.
La spécification v3 et la standardisation des catalogues REST autour d'Apache Polaris consolident cette position : deletion vectors, row lineage et VARIANT répondent à des besoins concrets de performance et de traitement incrémental, tandis que le catalogue devient le point central de la gouvernance. Face à Delta Lake, le choix tient moins à la technique qu'à la stratégie d'ouverture de l'organisation.
Pour un Data Engineer, savoir concevoir, maintenir et interroger des tables Iceberg devient une compétence différenciante, au même titre que la maîtrise de Spark ou de Parquet. À mesure que les plateformes convergent vers ce format commun, comprendre ses mécanismes permet de bâtir des architectures lakehouse durables, capables d'évoluer avec les moteurs et les usages de demain.