Modèles d'embedding : bien choisir pour son RAG
Lorsqu'un RAG répond mal, le réflexe est de changer de LLM, de retoucher le prompt ou de revoir le découpage des documents. Plus rarement, on s'interroge sur la brique qui décide pourtant de ce que le modèle va lire : le modèle d'embedding. C'est lui qui transforme chaque chunk et chaque question en vecteur, et donc qui détermine quels passages remontent lors de la recherche. Un mauvais choix à cette étape ne se rattrape pas en aval : si le bon passage n'est pas récupéré, aucun LLM ne pourra le citer.
Équipe Blent
Publié le · 13 min de lecture
Dans cet article
Lorsqu'un RAG répond mal, le réflexe est de changer de LLM, de retoucher le prompt ou de revoir le découpage des documents. Plus rarement, on s'interroge sur la brique qui décide pourtant de ce que le modèle va lire : le modèle d'embedding. C'est lui qui transforme chaque chunk et chaque question en vecteur, et donc qui détermine quels passages remontent lors de la recherche. Un mauvais choix à cette étape ne se rattrape pas en aval : si le bon passage n'est pas récupéré, aucun LLM ne pourra le citer.
Le catalogue est pourtant vaste et mouvant : API propriétaires, modèles open source de quelques centaines de millions à huit milliards de paramètres, classements publics, vecteurs de 384 à 4 096 dimensions, techniques de compression. Pour un AI Engineer, la question n'est pas « quel est le meilleur modèle ? » mais « quel est le meilleur compromis pour mes données, ma langue, mon budget et mon infrastructure ? ».
Dans cet article, nous allons rappeler le fonctionnement des embeddings de texte, apprendre à lire le benchmark MTEB, comparer les modèles open source et les API en insistant sur le multilinguisme et le français, puis voir comment réduire le coût de stockage grâce à la dimension réduite et à la quantization des vecteurs, avant de conclure sur la méthode la plus fiable : évaluer sur ses propres données.
Comment fonctionne un modèle d'embedding
Un modèle d'embedding est un réseau de neurones, le plus souvent un encodeur de type transformer, qui convertit un texte de longueur variable en un vecteur de dimension fixe. La propriété recherchée est géométrique : deux textes de sens proche doivent produire deux vecteurs proches, alors que deux textes sans rapport doivent s'éloigner. La recherche sémantique consiste alors à vectoriser la question, puis à retrouver dans une base vectorielle les chunks dont les vecteurs sont les plus proches, généralement avec la similarité cosinus. Ce principe est celui des word embeddings, étendu à des phrases et des paragraphes entiers.
Techniquement, le texte est d'abord découpé en tokens (voir notre article sur la tokenization), puis le transformer produit une représentation pour chaque token. Une étape de pooling les agrège en un seul vecteur : moyenne des représentations, token spécial de début de séquence, ou dernier token pour les modèles issus de LLM génératifs. Ces modèles sont ensuite entraînés par apprentissage contrastif sur des millions de paires (question, passage pertinent) : le vecteur d'une question est rapproché de celui de son passage et éloigné de ceux des autres passages du lot.
Quelques caractéristiques techniques conditionnent le choix et l'usage d'un modèle :
- La dimension : taille du vecteur produit (384, 768, 1024, 3072...). Elle pilote directement le coût de stockage et la vitesse de recherche.
- La longueur de contexte : nombre maximal de tokens accepté en entrée, de 512 pour la génération BERT à 8 192 ou 32 000 pour les modèles récents. Au-delà, le texte est tronqué sans avertissement.
- Les préfixes d'instruction : beaucoup de modèles attendent un préfixe différent pour les requêtes et les documents (« query: » et « passage: » pour la famille E5). Les oublier dégrade nettement les résultats.
Le code suivant montre l'usage typique avec Sentence Transformers :
from sentence_transformers import SentenceTransformer

# Modèle multilingue open source (1024 dimensions, contexte de 8192 tokens)
model = SentenceTransformer("BAAI/bge-m3")

documents = [
    "Le préavis de démission d'un cadre est généralement de trois mois.",
    "La sauvegarde des bases de données est planifiée chaque nuit.",
]
question = "Quelle est la durée du préavis pour un cadre ?"

# Normalisation : le produit scalaire équivaut alors au cosinus
doc_vectors = model.encode(documents, normalize_embeddings=True)
query_vector = model.encode(question, normalize_embeddings=True)

print(model.similarity(query_vector, doc_vectors))  # le premier document l'emporte
Question et documents doivent être vectorisés avec le même modèle, dans la même version. Changer de modèle impose de réindexer tout le corpus, ce qui rend le choix initial engageant.
Lire le benchmark MTEB sans se tromper
Pour comparer les modèles, la référence est le MTEB (Massive Text Embedding Benchmark), publié en 2022 et hébergé sous forme de classement public sur Hugging Face. Il évalue les modèles sur plusieurs familles de tâches : récupération d'information (retrieval), classification, clustering, classification de paires, reranking, similarité sémantique de phrases, résumé et alignement de textes bilingues. Le score affiché est une moyenne de ces tâches. Sa déclinaison multilingue, MMTEB, couvre des centaines de tâches dans plus de 250 langues.
Le classement est un excellent point de départ pour constituer une liste de candidats, mais il se lit avec précaution :
- Le score moyen masque la tâche qui vous intéresse : pour un RAG, seule la colonne retrieval compte vraiment. Un modèle brillant en classification peut être médiocre en recherche documentaire. Filtrez le classement sur la bonne catégorie de tâches.
- Les jeux de données sont publics : un modèle peut avoir été entraîné, volontairement ou non, sur des données proches de celles du benchmark. Le classement affiche d'ailleurs un indicateur de recouvrement avec les données d'entraînement. Un score exceptionnel obtenu sur des tâches vues pendant l'entraînement ne garantit rien sur vos documents.
- La taille et la latence sont absentes du score : un modèle de huit milliards de paramètres dominera un modèle de 300 millions, mais coûtera bien plus cher à l'indexation et à l'inférence.
Retenez trois à cinq candidats de profils différents (une API, un gros modèle open source, un petit modèle efficace), puis départagez-les sur vos propres données.
Modèles open source et API : panorama
Deux grandes familles coexistent, avec des logiques économiques et opérationnelles opposées. Le tableau suivant résume quelques modèles représentatifs, dont les caractéristiques évoluent : vérifiez toujours la fiche officielle avant de décider.
| Modèle | Type | Points forts | Points d'attention |
|---|---|---|---|
| Qwen3-Embedding (0,6B, 4B, 8B) | Open source (Apache 2.0) | Très haut niveau sur le classement multilingue, dimensions ajustables, contexte long | Le modèle 8B demande un GPU conséquent |
| BGE-M3 | Open source (MIT) | Plus de 100 langues, contexte de 8 192 tokens, vecteurs denses, parcimonieux et multi-vecteurs | Plus ancien que les modèles les plus récents |
| EmbeddingGemma (environ 300M) | Open source (licence Gemma) | Très léger, adapté au CPU et aux appareils locaux, dimensions réductibles | Contexte plus court, licence spécifique |
| multilingual-e5-large | Open source (MIT) | Robuste et très répandu, bon rapport qualité et simplicité | Préfixes « query: » et « passage: » obligatoires, contexte de 512 tokens |
| text-embedding-3 (OpenAI) | API | Deux tailles (small et large), paramètre dimensions, intégration simple | Dépendance à un fournisseur, données envoyées à l'extérieur |
| Gemini Embedding (Google) | API | Très bien classé en multilingue, dimensions réductibles | Même dépendance, quotas à surveiller |
Une API embedding se met en œuvre en une dizaine de lignes, sans GPU, et suit les progrès du fournisseur. Elle facture au token, ce qui pèse sur un grand corpus, et suppose d'envoyer les documents à un tiers. Un modèle open source s'héberge chez vous, garantit la confidentialité et un coût prévisible, mais exige de l'exploitation (GPU ou CPU, serveur d'inférence, monitoring).
Dans les deux cas, prévoyez dès le départ un pipeline capable de réindexer le corpus complet, et conservez dans vos métadonnées le nom et la version du modèle qui a produit chaque vecteur.
Multilinguisme et français
Un corpus francophone pose des difficultés spécifiques. Les modèles anglophones, entraînés sur des données majoritairement en anglais, perdent en précision sur le français : accents, conjugaisons, vocabulaire juridique ou administratif. Il faut donc privilégier un modèle multilingue, entraîné sur des paires de textes dans de nombreuses langues, ou un modèle explicitement adapté au français.
Deux situations se présentent en pratique :
- Corpus et questions en français : la plupart des modèles multilingues récents (Qwen3-Embedding, BGE-M3, multilingual-e5, Gemini Embedding, Cohere Embed) offrent un bon niveau. La différence se joue sur les spécificités de votre domaine.
- Questions en français, documents en anglais (ou l'inverse) : c'est le cas cross-lingue. Les modèles multilingues alignent les langues dans un même espace vectoriel, de sorte qu'une question française retrouve un passage anglais. Cette capacité varie sensiblement d'un modèle à l'autre et doit être testée.
Le classement MTEB propose des sous-ensembles dédiés au français, utiles comme premier filtre, mais qui ne remplacent pas un test sur des documents réels (contrats, procédures internes, tickets de support), dont le vocabulaire diffère des données publiques.
La longueur des chunks se vérifie en tokens avec le tokenizer du modèle retenu : un texte français en consomme plus qu'un texte anglais équivalent, ce qui compte avec un contexte de 512 tokens.
Dimension, Matryoshka et quantization
Une fois le modèle choisi, le coût de stockage devient le sujet suivant. Un vecteur de 1 024 dimensions en float32 occupe 4 Ko. Pour 10 millions de chunks, cela représente environ 41 Go de vecteurs, auxquels s'ajoutent l'index de recherche (HNSW par exemple) et ses surcoûts. Deux leviers permettent de réduire cette empreinte : diminuer le nombre de dimensions, ou diminuer la précision de chaque valeur.
Matryoshka embeddings : réduire la dimension
Les Matryoshka embeddings (Matryoshka Representation Learning) sont entraînés de sorte que les premières dimensions du vecteur concentrent l'information la plus importante, à la manière des poupées russes qui s'emboîtent. On peut alors tronquer le vecteur à 512, 256 ou 128 dimensions en conservant l'essentiel de sa qualité, sans réentraîner quoi que ce soit.
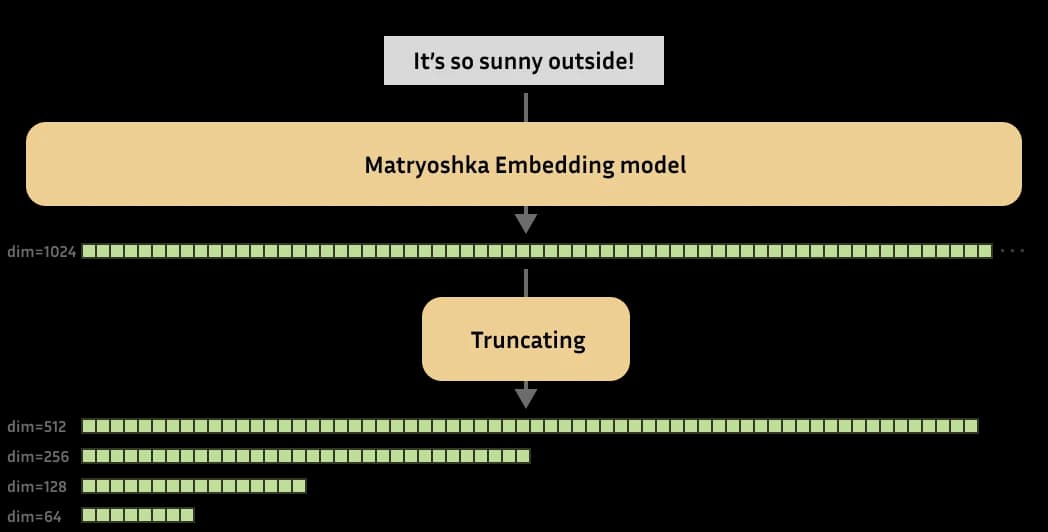
Cette propriété n'est pas automatique : seuls les modèles entraînés avec une perte spécifique (MatryoshkaLoss dans Sentence Transformers) la possèdent, comme Qwen3-Embedding, EmbeddingGemma, Nomic Embed v1.5, OpenAI text-embedding-3 ou Gemini Embedding. Tronquer un autre modèle dégrade fortement les résultats. L'usage avec Sentence Transformers tient en un paramètre :
from sentence_transformers import SentenceTransformer

# Tronque les vecteurs à 256 dimensions (le modèle doit être entraîné en Matryoshka)
model = SentenceTransformer("google/embeddinggemma-300m", truncate_dim=256)

vectors = model.encode(
    ["Comment réinitialiser mon mot de passe ?"],
    normalize_embeddings=True,
)
print(vectors.shape)  # (1, 256)
Une stratégie efficace consiste à présélectionner des candidats avec des vecteurs courts, puis à les reclasser avec les vecteurs complets ou avec un reranker. La perte dépend du modèle et des données : mesurez-la.
Quantization des vecteurs
La quantization réduit la précision numérique des valeurs du vecteur, un principe proche de celui que nous décrivons pour les poids des modèles dans notre article sur la quantization des LLM. Deux niveaux sont courants :
- int8 : chaque valeur est stockée sur un octet au lieu de quatre, soit une réduction d'un facteur 4. La perte de qualité est généralement faible.
- binaire : chaque valeur est réduite à un bit (son signe), soit une réduction d'un facteur 32. La comparaison se fait par distance de Hamming, très rapide, mais la perte de qualité est plus marquante.
| Précision | Octets par vecteur (1 024 dim.) | 10 millions de vecteurs | Facteur |
|---|---|---|---|
| float32 | 4 096 | environ 41 Go | 1x |
| int8 | 1 024 | environ 10 Go | 4x |
| binaire | 128 | environ 1,3 Go | 32x |
Pour limiter la perte, on utilise souvent un rescoring : une recherche large avec les vecteurs binaires, puis un reclassement des meilleurs candidats avec les vecteurs en pleine précision (stockés sur disque) ou en int8. Sentence Transformers fournit une fonction pour quantifier les embeddings :
from sentence_transformers import SentenceTransformer
from sentence_transformers.quantization import quantize_embeddings

model = SentenceTransformer("BAAI/bge-m3")
corpus = ["Premier chunk du corpus.", "Deuxième chunk du corpus.", "Troisième chunk."]
embeddings = model.encode(corpus, normalize_embeddings=True)

# Binaire non signé : 1024 bits regroupés en 128 octets par vecteur
binary = quantize_embeddings(embeddings, precision="ubinary")
print(binary.shape, binary.dtype)  # (3, 128) uint8
Plusieurs bases vectorielles proposent aussi leur propre quantization intégrée. Les deux leviers se combinent : un vecteur Matryoshka de 256 dimensions quantifié en binaire occupe 32 octets, soit 128 fois moins que le vecteur d'origine, au prix d'une perte de précision qu'il faut impérativement mesurer.
Évaluer sur ses propres données
Aucun classement ne remplace une évaluation sur votre contenu. La démarche tient en quelques étapes et prend rarement plus d'une journée, ce qui est faible au regard de l'enjeu.
- Constituer un jeu de test : 50 à 200 questions réelles (issues de logs, de tickets, d'utilisateurs) associées au chunk ou au document qui contient la réponse. À défaut, générer des questions synthétiques avec un LLM à partir de chunks tirés au hasard, puis relire un échantillon pour écarter les questions mal formées.
- Indexer le corpus avec chaque candidat : même découpage, seul le modèle change.
- Mesurer le retrieval : le recall@k (la bonne réponse figure-t-elle dans les k premiers résultats ?) et le MRR (à quelle position apparaît-elle ?) sont les métriques de base. Nous détaillons les métriques de bout en bout dans notre article sur l'évaluation d'un RAG.
- Arbitrer : qualité, mais aussi latence, coût d'indexation, stockage et exploitation.
Le script suivant compare plusieurs modèles sur un jeu de test minimal :
import numpy as np
from sentence_transformers import SentenceTransformer

# Jeu de test : chaque question pointe vers l'indice du chunk attendu
chunks = ["Texte du chunk 0...", "Texte du chunk 1...", "Texte du chunk 2..."]
tests = [("Question dont la réponse est dans le chunk 1 ?", 1)]


def recall_at_k(model_name: str, k: int = 5) -> float:
    """Calcule le recall@k d'un modèle sur le jeu de test."""
    model = SentenceTransformer(model_name)
    chunk_vectors = model.encode(chunks, normalize_embeddings=True)
    hits = 0
    for question, expected in tests:
        query_vector = model.encode(question, normalize_embeddings=True)
        scores = chunk_vectors @ query_vector
        top_k = np.argsort(scores)[::-1][:k]
        hits += int(expected in top_k)
    return hits / len(tests)


for name in ["BAAI/bge-m3", "intfloat/multilingual-e5-large"]:
    print(name, recall_at_k(name))
Les modèles qui attendent des préfixes ou des instructions (famille E5, Qwen3-Embedding) doivent recevoir les bons préfixes, sans quoi la comparaison est faussée. Une fois le gagnant identifié, testez ses variantes (dimension réduite, quantization, longueur de chunk). Combiner enfin la recherche vectorielle avec une recherche lexicale (BM25) par Reciprocal Rank Fusion compense souvent les faiblesses d'un modèle sur les noms propres, les références produit ou les sigles internes.
À découvrir : notre formation LLM Engineering
Conclusion
Le modèle d'embedding est la fondation silencieuse d'un RAG : il décide de ce que le LLM verra, et donc de ce qu'il pourra dire. Le choisir sur la seule foi d'un classement, ou par habitude d'utiliser l'API la plus connue, revient à construire sur une base dont on ignore la solidité.
Le MTEB permet de constituer une liste de candidats, à condition de regarder la colonne retrieval, la taille du modèle et l'origine des scores. Le choix entre API et open source dépend de la confidentialité, du volume et de la capacité d'exploitation. Pour le français, un modèle multilingue récent est le point de départ, à valider sur des documents réels. Les Matryoshka embeddings et la quantization réduisent le coût de stockage d'un facteur de 4 à plus de 100, à condition de mesurer la perte de qualité.
La compétence qui distingue une équipe mature n'est pas de connaître le modèle du moment, vite dépassé, mais de disposer d'un jeu d'évaluation et d'un pipeline de réindexation qui permettent de changer de modèle en confiance. Avec ces deux outils, chaque nouvelle publication devient une opportunité à tester plutôt qu'un choix à subir.