Blog IA, Data Science & MLOps
Tutoriels, guides et analyses sur l'IA, la Data et le Cloud, écrits par les ingénieurs et mentors Blent.
214 articles · page 5 sur 6
 Machine Learning
Hugging Face : tout savoir sur la startup Deep Learning
Hugging Face est une startup française qui s'est fait connaître grâce à l'infrastructure NLP qu'ils ont développée. Aujourd'hui, elle est sur le point de révolutionner le domaine du Machine Learning et traitement automatique du langage naturel. Dans cet article, nous allons présenter Hugging Face et détailler les taches de base que cette librairie permet de réaliser. Nous allons également énumérer ses avantages et ses alternatifs.
8 min de lecture
 Machine Learning
SpaCy : comment l'utiliser sous Python?
spaCy est une bibliothèque open-source pour le traitement avancé du langage naturel. Elle est conçue spécifiquement pour une utilisation en production et permet de construire des applications qui traitent et comprennent de grands volumes de texte.
10 min de lecture
 Machine Learning
Auto-encodeurs en Deep Learning : tout savoir
Un auto-encodeur est une structure de réseaux neuronaux profonds qui s'entraîne pour réduire la quantité de données nécessaires pour représenter une donnée d'entrée. Ils sont couramment utilisés en apprentissage automatique pour effectuer des tâches de compression de données, d'apprentissage de représentations et de détection de motifs.
9 min de lecture
- Machine Learning
Réseaux récurrents (RNN) : on vous explique tout
Les réseaux neuronaux récurrents ou les RNNs en abrégé sont une variante des réseaux neuronaux artificiels qui peuvent traiter des données séquentielles et peuvent être entrainés pour détenir les connaissances sur le passé. Les RNNs sont couramment utilisés dans les domaines de l'apprentissage automatique, de traitement de langage naturel et de reconnaissance de formes.
9 min de lecture
 Machine Learning
Réseaux convolutifs (CNN) : comment ça marche ?
Les réseaux neuronaux sont un sous-ensemble de l’apprentissage automatique, et ils sont au cœur des algorithmes d’apprentissage profond. Inventés par Yann LeCun durant les années 90, les CNNs sont inspirés des réseaux neuronaux biologiques, et ils sont devenus extrêmement populaires en raison de leurs performances dans les domaines de la vision et plusieurs autres domaines.
11 min de lecture
 Machine Learning
GAN et Deep Learning : créer des données de toute pièces
Les GANs sont des modèles génératifs : ils créent de nouvelles instances de données qui ressemblent à vos données de formation. Par exemple, ils peuvent créer des images qui ressemblent à des photographies de visages humains, même si les visages n’appartiennent à aucune personne réelle.
8 min de lecture
 Machine Learning
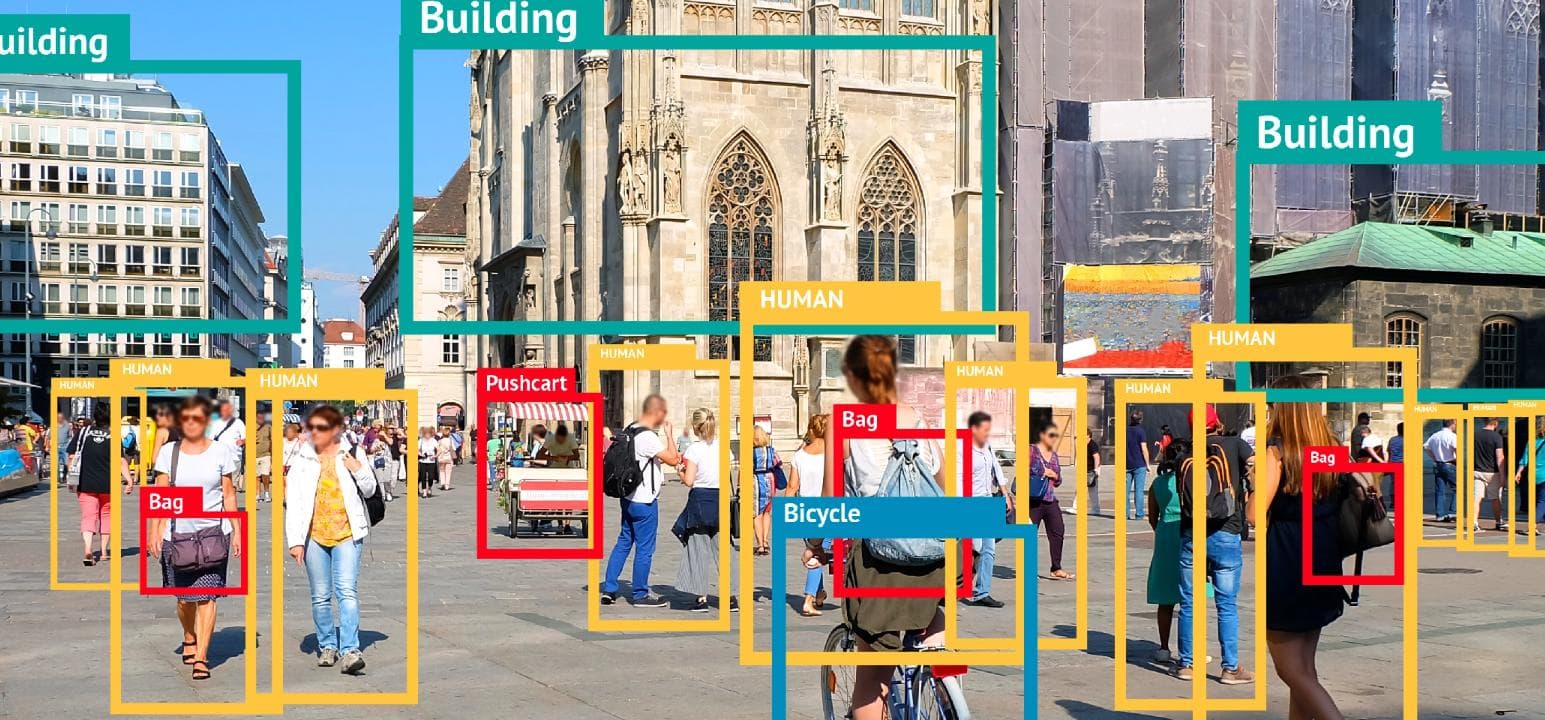
YOLO : détection sur les images avec TensorFlow
Au cours des dernières années, les modèles Deep Learning ont gagné en renommée pour leur capacité à traiter l’information visuelle et ils sont devenus un élément clé de nombreuses applications de vision par ordinateur. Parmi les principaux problèmes que ces modèles peuvent résoudre est la détection et la localisation des objets dans les images.
10 min de lecture
 Machine Learning
TensorFlow : Deep Learning sous Python
Depuis quelques années, les librairies et boîtes à outils informatiques destinées à l’intelligence artificielle se multiplient. En effet, de nombreuses entreprises ont décidé de se doter d’un service d’intelligence artificielle pour traiter leurs données et élaborer des modèles prédictifs.
9 min de lecture
 Machine Learning
Modèles de Machine Learning les plus populaires
Dans cet article, nous allons expliquer ce que sont les algorithmes d’apprentissage automatique, leurs types et nous allons présenter les modèles les plus populaires.
12 min de lecture
 Machine Learning
Matplotlib : faire des graphiques en Python
Matplotlib est l’une des bibliothèques les plus puissantes et le plus utilisées en Python pour la visualisation de données. Elle permet nous permet de créer presque n’importe quelle visualisation que nous pourrions imaginer et en plus il y a un riche écosystème d’outils python construits autour d'elle et beaucoup d’outils de visualisation plus avancés utilisent Matplotlib comme bibliothèque de base.
9 min de lecture
 Machine Learning
Tests Python pour le Machine Learning
Dans l'univers du développement logiciel, les tests sont omniprésents. Ils permettent de vérifier que le logiciel ou l'application développée adopte correctement le comportement attendu, ne produit pas de bugs ou s'intègre efficacement dans un environnement existant.
9 min de lecture
 Machine Learning
Introduction à pandas sous Python
L'une des bibliothèques utiliser pour le prétraitement des données est Pandas. Si vous avez travaillé avec des données tabulaires avant, vous l'avez certainement utilisé. C'est une bibliothèque du langage de programmation Python utilisée pour la manipulation et l’analyse des données.
9 min de lecture
- Machine Learning
Seaborn : Data Visualization sous Python
Seaborn est une librairie de visualisation de données Python basée sur Matplotlib. Elle fournit une interface plus conviviale pour la création de certaines visualisations de données, notamment les diagrammes de dispersion et les histogrammes.
7 min de lecture
 Data Engineering
BigQuery : le Data Warehouse de Google
Google BigQuery est un Data Warehouse en ligne qui permet aux utilisateurs de stocker, analyser et visualiser des données volumineuses. BigQuery offre une interface web pour executer des requêtes SQL sur les données stockées, ainsi qu'une API pour intégrer BigQuery à d'autres applications.
6 min de lecture
 Machine Learning
Surapprentissage : comment l’éviter ?
L’un des obstacles les plus délicats dans l’apprentissage automatique est le surapprentissage ou le overfitting en anglais. Un modèle de Machine Learning doit être capable de généraliser, c'est-à-dire qu'il doit pouvoir prendre de nouvelles observations et prédire avec une certaine précision la variable cible associée.
10 min de lecture
 Data Engineering
Confluent Platform : la plateforme Data Streaming tout-en-un
Confluent Platform est une plateforme de données spécialisée dans l'ingestion, la distribution et le traitement de données en temps réel. Basé sur la plateforme Apache Kafka et développée par les mêmes créateurs que cette dernière, elle est devenue incontournable pour beaucoup d'équipes et de Data Engineer, car elle vient compléter Apache Kafka avec de nombreuses fonctionnalités.
12 min de lecture
 Machine Learning
L’apprentissage supervisé : définition et exemples
L’apprentissage supervisé est une sous-catégorie de l’apprentissage automatique et de l’intelligence artificielle. Il est défini par son utilisation d’ensembles de données étiquetés pour former des algorithmes qui permettent de classer les données ou de prédire les résultats avec précision. L'objectif est de donner un sens aux données dans le contexte d’une question spécifique.
10 min de lecture
 Cloud / DevOps
Terraform : automatiser son infrastructure Cloud
Construire une infrastructure Cloud peut vite devenir difficile à gérer pour toute une équipe, surtout si elle doit faire des modifications sur plusieurs services à la fois. C'est là qu'intervient Terraform, un outil d'Infrastructure-as-Code très populaire qui permet de construire et déployer toute une infrastructure Cloud à l'aide de fichiers de configuration.
8 min de lecture
 Machine Learning
Les Transformers, incontournables du Deep Learning
Les transformers, ou les modèles séquence à séquence, sont des modèles de Deep Learning qui appartiennent à une classe spéciale d’architectures de réseaux de neurones récurrents. Ils sont devenus des modèles de choix pour les Data Scientists lorsqu'ils travaillent sur du texte, remplaçant les anciens RNNs tels que le LSTM ou le GRU.
9 min de lecture
 Cloud / DevOps
Cloud Computing : tout savoir en 10 minutes
Pour toute entreprise qui souhaite proposer des services numériques, le Cloud est devenu absolument incontournable. Il permet non seulement de délocaliser les ressources informatiques, de déployer une application à l'échelle de la planète et utiliser un nombre impressionnant de services, le tout à moindres coûts. Toutes les entreprises numériques, de toutes les tailles, utilisent le Cloud pour exécuter l'intégralité ou une partie de leur infrastructure informatique.
12 min de lecture
 Machine Learning
Validation croisée en Machine Learning
Un modèle entraîné sur un jeu de données est capable de prédire les étiquettes des éléments de ce dernier. Mais une fois testé sur d'autres éléments, ce n'est pas vraiment certain qu'il ait la bonne réponse. C’est pourquoi vérifier la capacité de l’algorithme à généraliser est une tâche importante qui nécessite beaucoup d’attention lors de la construction du modèle. Pour ce faire, on utilise la validation croisée.
11 min de lecture
 Machine Learning
IA responsable et de confiance : de quoi s'agit-il ?
Nous avons récemment eu le plaisir d'organiser un Webinar avec Labelia lab (ex-Substra Foundation). Nous avons eu la chance de recevoir Eric Boniface, cofondateur et directeur de Labelia, qui est venu nous présenter Labelia ainsi que les raisons qui ont amené à sa création.
7 min de lecture
 Machine Learning
Feature Engineering : définition et exemples
L’ingénierie des fonctionnalités ou en anglais, Feature Engineering est le processus de sélectionner et transformer les variables les plus pertinentes à partir de données brutes, dans l'objectif d’obtenir les meilleurs performances pour les modèles de Machine Learning. Cette notion est une partie indispensable du prétraitement des données et elle est reconnue pour être la clé du succès dans le domaine du Machine Learning.
10 min de lecture
 Data Engineering
NoSQL : définitions et exemples
Le NoSQL est une famille de bases de données qui ont la particularité de prendre en charge un modèle de données non relationnelles. À l'opposé des bases de données traditionnelles dites SQL, les bases NoSQL ont fait leur apparition avec le Big Data, dès lors qu'il fallait pour stocker, historiser et requêter sur des volumétries très importantes.
7 min de lecture
 Machine Learning
Algorithme t-SNE : comment ça fonctionne ?
La réduction de dimension est une technique très populaire, généralement utilisée par les Data Scientists pour améliorer la performance des algorithmes de Machine Learning, surtout lorsqu'on travaille avec des jeux de données à plusieurs variables. Elle permet d'éliminer les variables corrélées qui ne contribuent à aucune prise de décision. Il existe plusieurs approches pour ce faire, dont t-SNE, un algorithme d’apprentissage non supervisé connu notamment pour sa capacité à faciliter la visualisation des données non linéaires ayant beaucoup de descripteurs.
9 min de lecture
 Machine Learning
U-Net : le réseau de neurones populaire en Computer Vision
L'une de ces architectures dont en parle très souvent en Computer Vision est le U-Net. Ayant fait ces preuves en termes de précision et rapidité, le U-Net est maintenant le plus utilisé pour la segmentation d'images, surtout dans le domaine d'imagerie biomédicale.
9 min de lecture
 Cloud / DevOps
Équilibrage de charge : définition et exemples
L'équilibrage de charge (ou Load Balancing en anglais) est une technique d'architecture informatique qui permet, comme son nom l'indique, de répartir la charge (les requêtes) vers plusieurs cibles d'un même groupe. Très souvent utilisé pour les applications Web, l'équilibrage de charge est une pratique incontournable dès que l'on souhaite redimensionner une application.
7 min de lecture
 Data Engineering
Scala : tout savoir sur le langage fonctionnel
Scala tire son nom de « scalable language » car il a été pensé pour être utilisé à n'importe quelle échelle : de simples scripts jusqu'à de larges systèmes. Développé initialement en 2004 à l'EPFL, Scala s'intègre complètement avec Java et s'exécute en tant que plateforme Java.
9 min de lecture
 Machine Learning
LightGBM : mieux que XGBoost ?
Les modèles basés sur le renforcement de gradient et leurs variantes offertes par plusieurs communautés ont gagné beaucoup de traction ces dernières années. LightGBM, développé par Microsoft et publié en 2016, représente un exemple très populaire. Il est rapide, distribué et de haute performance. Basé sur des algorithmes d'arbre de décision, il est utilisé pour le classement, la classification et de nombreuses autres tâches de Machine Learning. Il représente aussi une excellente alternative à XGBoost.
8 min de lecture
 Cloud / DevOps
Docker, à quoi ça sert ?
Docker est une plateforme de conteneurs open source qui permet de créer des environnements isolés sur un seul et même système. Il permet de faciliter le déploiement et la mise à l'échelle au niveau applicatif. Aujourd'hui, Docker est la plateforme la plus populaire et la plus utilisée, en grande partie grâce à sa simplicité d'utilisation.
6 min de lecture
 Machine Learning
L’ACP : tout savoir sur l’Analyse en Composantes Principales
Si vous avez déjà travaillé avec des jeux de données contenant beaucoup de variables, vous savez que cela peut présenter des problèmes. Pour éviter tout cela, les Data Scientists ont recours généralement à l'ACP ou l’Analyse en Composantes Principales.
9 min de lecture
 Cloud / DevOps
Serverless : définition, exemples
Le Serverless (sans serveur) regroupe un ensemble de services dans le Cloud où l'exécution d'une application ou d'un programme est réalisée sans que le développeur manipule et administre l'infrastructure sous-jacente.
6 min de lecture
 Machine Learning
SVM : Support Vector Machine
SVM (Support Vector Machine ou Machine à vecteurs de support) est un algorithme d’apprentissage automatique supervisé qui peut être utilisé pour les problèmes de classification ou de régression. Toutefois, il est surtout utilisé dans les problèmes de classification.
8 min de lecture
 Data Engineering
Spark Streaming : Bien démarrer
Spark Streaming est l'API dédiée au traitement de données en temps réel basé sur Apache Spark. Celui-ci est bien connu pour sa puissance concernant la parallélisation de calculs très volumineux. Outre son interaction facile en Python, il dispose également d'une API haut-niveau avec la définitions d'objets tels que les DataFrames, très puissant pour manipuler des tableaux de données.
8 min de lecture
 Machine Learning
XGBoost : Tout savoir sur le Boosting
XGBoost est un modèle de Machine Learning très populaire chez les Data Scientists. Ayant fait ses preuves en termes de performance et de vitesse, il a récemment dominé les hackathons et compétitions de Machine Learning, ainsi que les concours de Kaggle pour les données structurées ou tabulaires.
10 min de lecture
 Cloud / DevOps
Git - Tutoriel complet
Git est un système de versions distribué, c'est-à-dire un outil qui permet le contrôle des versions d'un projet, qu'il y ait un ou plusieurs contributeurs. Ce besoin de gérer les versions est d'autant plus renforcé que les environnements sont de plus en plus décentralisés sous forme de microservices, rendant les itérations de développement de plus en plus courtes.
13 min de lecture
